Cette rubrique explique comment utiliser Spark pour lire des données provenant de plusieurs types de sources et les écrire dans Hologres.
Informations générales
Spark est un moteur d'analyse qui traite de grands volumes de données de manière centralisée. Hologres s'intègre à la fois à Apache Spark et à E-MapReduce (EMR) Spark pour vous aider à construire des entrepôts de données de manière efficace. Hologres fournit le connecteur Spark, que vous pouvez utiliser pour écrire des données dans Hologres en mode batch. Vous pouvez utiliser Spark pour lire des données à partir de multiples sources, telles que des fichiers, des tables Hive, des tables MySQL et des tables PostgreSQL.
Hologres est compatible avec PostgreSQL. Vous pouvez utiliser Spark pour lire les données Hologres via PostgreSQL. Ensuite, vous pouvez extraire, transformer et charger (ETL) les données, puis écrire les données traitées de nouveau dans Hologres ou vers d'autres destinations.
Prérequis
La version de votre instance Hologres doit être la V0.9 ou une version ultérieure. Vous pouvez consulter la version de votre instance Hologres sur la page des détails de l'instance dans la console Hologres. Si la version de votre instance Hologres est antérieure à la V0.9, mettez à niveau manuellement votre instance Hologres dans la console Hologres ou rejoignez le groupe DingTalk Hologres pour obtenir une assistance technique. Pour plus d'informations sur la mise à niveau manuelle de votre instance Hologres dans la console Hologres, consultez la section Mises à niveau des instances. Pour plus d'informations sur l'obtention d'une assistance technique, consultez la section Obtenir une assistance en ligne pour Hologres.
Un environnement Spark d'une version prise en charge par Hologres est installé. Cela vous permet d'exécuter la commande
spark-shelldans l'environnement Spark.
Utilisation des connexions
Lorsque vous utilisez le connecteur Spark de Hologres pour lire ou écrire des données, des connexions Java Database Connectivity (JDBC) sont employées. Le nombre de connexions utilisées dépend des éléments suivants :
Nombre de tâches Spark parallèles : vous pouvez obtenir ce nombre dans l'interface utilisateur de Spark lorsqu'un job est en cours d'exécution.
Mode d'écriture des données : si vous utilisez le connecteur Spark pour écrire des données en mode copy fixe, chaque tâche parallèle utilise une connexion JDBC. Si vous utilisez l'instruction INSERT pour écrire des données, le nombre de connexions JDBC utilisées par chaque tâche parallèle correspond à la valeur de write_thread_size. Chaque tâche parallèle de lecture de données utilise une connexion JDBC.
Autres : au démarrage d'un job, il peut être nécessaire d'obtenir des informations de schéma. Dans ce cas, une connexion JDBC peut être utilisée pendant une courte période.
Le nombre total de connexions JDBC utilisées par un job peut être calculé à l'aide des formules suivantes :
Mode copy fixe :
Parallelism × 1 + 1Instruction INSERT :
Parallelism × write_thread_size + 1
Le parallélisme des tâches Spark est influencé par les paramètres manuels et la politique de blocage des fichiers de Hadoop.
(Recommandé) Utiliser le connecteur Spark pour écrire des données dans Hologres
Nous vous recommandons d'utiliser le connecteur Spark intégré de Hologres pour écrire des données dans Hologres. Le connecteur Spark fonctionne conjointement avec Holo Client. Par rapport aux autres méthodes d'écriture de données, le connecteur Spark offre de meilleures performances d'écriture. Pour utiliser le connecteur Spark afin d'écrire des données, suivez les étapes ci-dessous. Pour plus d'informations sur l'exemple de code, consultez la section Exemple d'utilisation du connecteur Spark pour écrire des données dans Hologres de cette rubrique.
Préparatifs
-
Obtenez un package JAR.
Le connecteur Spark est disponible pour Spark 2 et Spark 3. Lorsque vous utilisez le connecteur Spark pour écrire des données dans Hologres, vous devez référencer un package JAR du connecteur Spark. Ce package JAR est déjà publié dans le dépôt central Maven. Vous pouvez vous référer au fichier pom.xml suivant pour la configuration.
RemarqueLes connecteurs pertinents sont également open source. Pour plus d'informations, visitez la page alibabacloud-hologres-connectors.
<dependency>
    <groupId>com.alibaba.hologres</groupId>
    <artifactId>hologres-connector-spark-3.x</artifactId>
    <version>1.4.0</version>
    <classifier>jar-with-dependencies</classifier>
</dependency>
Vous pouvez cliquer sur les liens suivants pour télécharger les packages JAR fournis par Hologres :
-
Utilisez le package JAR.
Exécutez la commande suivante pour démarrer Spark et charger le connecteur :
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jarVous pouvez également exécuter la commande suivante pour démarrer PySpark et charger le connecteur :
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar
Exemple d'utilisation du connecteur Spark pour écrire des données dans Hologres
L'exemple suivant montre comment utiliser le connecteur Spark pour écrire des données dans Hologres.
-
Créez une table dans Hologres.
Exécutez l'instruction SQL suivante dans Hologres pour créer la table dans laquelle vous souhaitez écrire des données :
CREATE TABLE tb008 ( id BIGINT primary key, counts INT, name TEXT, price NUMERIC(38, 18), out_of_stock BOOL, weight DOUBLE PRECISION, thick FLOAT, time TIMESTAMPTZ, dt DATE, by bytea, inta int4[], longa int8[], floata float4[], doublea float8[], boola boolean[], stringa text[] ); -
Préparez les données dans Spark et écrivez-les dans Hologres.
-
Exécutez la commande suivante dans le CLI pour activer le connecteur Spark :
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Exécutez la commande
load spark-test.scaladans spark-shell pour charger les exemples de données.Le fichier spark-test.scala contient les données suivantes :
import java.sql.{Timestamp, Date}
import org.apache.spark.sql.types._
import org.apache.spark.sql.Row

val byteArray = Array(1.toByte, 2.toByte, 3.toByte, 'b'.toByte, 'a'.toByte)
val intArray = Array(1, 2, 3)
val longArray = Array(1L, 2L, 3L)
val floatArray = Array(1.2F, 2.44F, 3.77F)
val doubleArray = Array(1.222, 2.333, 3.444)
val booleanArray = Array(true, false, false)
val stringArray = Array("abcd", "bcde", "defg")

val data = Seq(
  Row(-7L, 100, "phone1", BigDecimal(1234.567891234), false, 199.35, 6.7F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("2021-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(6L, -10, "phone2", BigDecimal(1234.56), true, 188.45, 7.8F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("1970-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(1L, 10, "phone3\"", BigDecimal(1234.56), true, 111.45, null, Timestamp.valueOf("2020-02-29 00:12:33"), Date.valueOf("2020-07-23"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray)
)

val schema = StructType(Array(
  StructField("id", LongType),
  StructField("counts", IntegerType),
  StructField("name", StringType, false), // The value false indicates that the value of this field cannot be null in the table.
  StructField("price", DecimalType(38, 12)),
  StructField("out_of_stock", BooleanType),
  StructField("weight", DoubleType),
  StructField("thick", FloatType),
  StructField("time", TimestampType),
  StructField("dt", DateType),
  StructField("by", BinaryType),
  StructField("inta", ArrayType(IntegerType)),
  StructField("longa", ArrayType(LongType)),
  StructField("floata", ArrayType(FloatType)),
  StructField("doublea", ArrayType(DoubleType)),
  StructField("boola", ArrayType(BooleanType)),
  StructField("stringa", ArrayType(StringType))
))

val df = spark.createDataFrame(
  spark.sparkContext.parallelize(data),
  schema
)
df.show()

// Configure the following parameters to write the sample data to Hologres.
df.write.format("hologres") // Set the value to hologres.
  .option("username", "your_username") // The AccessKey ID of your Alibaba Cloud account.
  .option("password", "your_password") // The AccessKey secret of your Alibaba Cloud account.
  .option("endpoint", "Ip:Port") // The IP address and port number of your Hologres instance.
  .option("database", "test_database") // The name of the Hologres database. The name is test_database in this example.
  .option("table", "tb008") // The name of the Hologres table to which you want to write data. The table name is tb008 in this example.
  .option("write_batch_size", 512) // The maximum number of write requests allowed in a batch. For more information, see the parameter description in the "Use Spark to write data to Hologres in real time" section.
  .option("input_data_schema_ddl", df.schema.toDDL) // The data definition language (DDL) statement for DataFrame. This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // The save mode of the Spark DataFrameWriter interface. The value must be Append. This parameter differs from the WRITE_MODE parameter. The value OverWrite is supported for hologres-connector 1.3.3 and later. If you set this parameter to OverWrite, data in the source table is cleared. Proceed with cautions when you use this value.
  .save()
-
-
Interrogez les données dans la table de destination.
Vous pouvez interroger les données dans la table de destination via la console Hologres pour vérifier les données écrites. La figure suivante illustre un exemple.
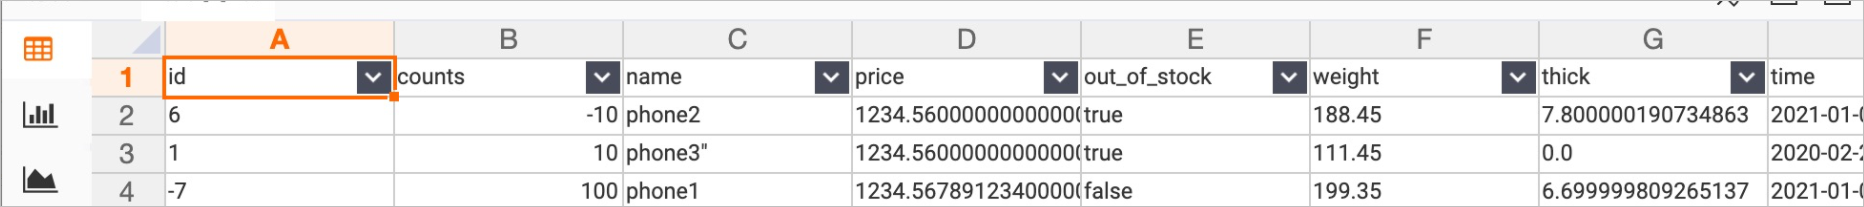
Exemple d'utilisation du connecteur PySpark pour écrire des données dans Hologres
-
Démarrez PySpark et chargez le connecteur PySpark.
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Utilisez les métadonnées pour créer un objet DataFrame et appelez le connecteur pour écrire des données dans Hologres. L'opération est similaire à celle effectuée lors de l'utilisation du connecteur Spark.
data = [[1, "Elia"], [2, "Teo"], [3, "Fang"]]
df = spark.createDataFrame(data, schema="id LONG, name STRING")
df.show()

df2.write.format("hologres").option(
  "username", "your_username").option(
  "password", "your_password").option(
  "endpoint", "hologres_endpoint").option(
  "database", "test_database").option(
  "table", "tb008").save()
Utiliser Spark SQL pour charger un connecteur pour l'écriture de données dans Hologres
Seul le connecteur Spark pour Spark 3 prend en charge ce mode.
-
Démarrez Spark SQL et chargez le connecteur Spark.
spark-sql --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Exécutez les instructions DDL Spark SQL suivantes pour créer une vue CSV et une vue Hologres, puis écrivez-y des données :
CREATE TEMPORARY VIEW csvTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING csv OPTIONS (
  path "resources/customer1.tbl", sep "|"
);

CREATE TEMPORARY VIEW hologresTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING hologres OPTIONS (
  jdbcurl "jdbc:postgresql://hologres_endpoint/test_database",
  username "your_username",
  password "your_password",
  table "customer_holo_table",
  copy_write_mode "true",
  bulk_load "true",
  copy_write_format "text"
);

-- You cannot write data to specific columns of Hologres views that are created by using SQL statements. For example, you cannot execute the insert into hologresTable(c_custkey) select c_custkey from csvTable statement. When you write data, you must write data to all columns that are declared in the DDL statement. If you want to write data to specific columns, you can declare only these columns when you create the table.
INSERT INTO hologresTable SELECT * FROM csvTable;
Utiliser Spark pour lire des données d'un type de source spécifique et les écrire dans Hologres
-
Lisez les données d'un type de source spécifique.
Vous pouvez utiliser Spark pour lire des données provenant de différents types de sources. Les exemples suivants montrent comment lire des données depuis Hologres ou un autre type de source :
-
Lire des données depuis Hologres
Hologres est compatible avec PostgreSQL. Vous pouvez utiliser Spark pour lire les données Hologres via le pilote JDBC PostgreSQL. Le code d'exemple suivant est fourni à titre de référence uniquement.
RemarqueAvant de lire les données Hologres, téléchargez le package PostgreSQL JDBC JAR sur le site officiel. Dans cet exemple,
postgresql-42.2.18est utilisé. Ensuite, exécutez la commande./bin/spark-shell --jars /path/to/postgresql-42.2.18.jardans spark-shell pour charger le package JAR JDBC PostgreSQL. Vous pouvez également charger le package JAR JDBC PostgreSQL conjointement avec le package JAR du connecteur Spark de Hologres.// Read from some table, for example: tb008 val readDf = spark.read .format("jdbc") // Read Hologres data based on the PostgreSQL JDBC driver. .option("driver","org.postgresql.Driver") .option("url", "jdbc:postgresql://Ip:Por/test_database") .option("dbtable", "tb008") .option("user", "your_username") .option("password", "your_password") .load()Les versions 1.3.2 et ultérieures du connecteur Spark vous permettent de lire des données depuis Hologres et d'optimiser les performances des lectures de données en parallèle. Par rapport au pilote JDBC PostgreSQL, le connecteur Spark vous permet de configurer le parallélisme de lecture des données et prend en charge le partitionnement des données dans Hologres pour mettre en œuvre des lectures de données en parallèle. Cela améliore considérablement les performances. Exemple de code :
val spark = SparkSession .builder .appName("ReadFromHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val schema = StructType(Array( StructField("id", LongType), StructField("counts", IntegerType), StructField("name", StringType, false), StructField("price", DecimalType(38, 12)), StructField("out_of_stock", BooleanType) )) val readDf = spark.read .format("hologres") .schema(schema) // Optional. If you do not specify a schema, all fields in the Hologres table are read by default. .option("username", "your_username") .option("password", "your_password") .option("jdbcurl", "jdbc:postgresql://hologres_endpoint/test_db") .option("table", "tb008") .option("scan_parallelism", "10") // The default parallelism for reading data from Hologres. The maximum value is the shard count of the Hologres table. .load() -
Lire des données depuis un autre type de source, tel qu'un fichier Parquet
Vous pouvez utiliser Spark pour lire des données depuis d'autres types de sources, telles qu'un fichier Parquet ou une table Hive. L'exemple suivant fournit le code d'exemple :
import org.apache.spark.{SparkConf, SparkContext}
import org.apache.spark.sql.hive.HiveContext

val sparkConf = new SparkConf()
val sc = new SparkContext(sparkConf)
val hiveContext = new HiveContext(sc)

// Read from some table, for example: phone
val readDf = hiveContext.sql("select * from hive_database.phone")
-
-
Écrivez les données dans Hologres.
import com.alibaba.hologres.spark2.sink.SourceProvider

-- Write to hologres table
df.write
  .format("hologres")
  .option(SourceProvider.USERNAME, "your_username")
  .option(SourceProvider.PASSWORD, "your_password")
  .option(SourceProvider.ENDPOINT, "Ip:Port")
  .option(SourceProvider.DATABASE, "test_database")
  .option(SourceProvider.TABLE, table)
  .option(SourceProvider.WRITE_BATCH_SIZE, 512) -- The maximum number of requests allowed in a batch.
  .option(SourceProvider.INPUT_DATA_SCHEMA_DDL, df.schema.toDDL) -- This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // This parameter is required only for Spark 3.X.
  .save()
Utiliser Spark pour écrire des données dans Hologres en temps réel
-
Exécutez l'instruction suivante pour créer la table de destination dans Hologres :
CREATE TABLE test_table_stream ( value text, count bigint ); -
Lisez les données depuis votre machine locale. Collectez les statistiques de fréquence des mots et écrivez-les dans Hologres en temps réel. L'exemple ci-dessous illustre le code à utiliser :
-
Code
val spark = SparkSession .builder .appName("StreamToHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val lines = spark.readStream .format("socket") .option("host", "localhost") .option("port", 9999) .load() -- Split the lines into words val words = lines.as[String].flatMap(_.split(" ")) -- Generate running word count val wordCounts = words.groupBy("value").count() wordCounts.writeStream .outputMode(OutputMode.Complete()) .format("hologres") .option(SourceProvider.USERNAME, "your_username") .option(SourceProvider.PASSWORD, "your_password") .option(SourceProvider.JDBCURL, "jdbc:postgresql://Ip:Port/dbname") .option(SourceProvider.TABLE, "test_table_stream") .option("batchsize", 1) .option("isolationLevel", "NONE") .option("checkpointLocation", checkpointLocation) .start() .awaitTermination() -
Paramètres
Parameter
Default value
Required
Description
username
No default value
Yes
ID AccessKey de votre compte Alibaba Cloud. Vous pouvez obtenir cet identifiant sur la page Security Management.
Il est recommandé de configurer des variables d'environnement pour récupérer l'AccessKey ID et l'AccessKey secret, afin de réduire les risques de fuite.
password
No default value
Yes
AccessKey secret de votre compte Alibaba Cloud. Vous pouvez obtenir cette clé secrète sur la page Security Management.
Il est recommandé de configurer des variables d'environnement pour récupérer l'AccessKey ID et l'AccessKey secret, afin de réduire les risques de fuite.
table
No default value
Yes
Nom de la table Hologres dans laquelle vous souhaitez écrire les données.
endpoint
No default value
Configurez ce paramètre ou le paramètre JDBCURL.
Endpoint de votre instance Hologres.
Vous pouvez retrouver l'endpoint de votre instance Hologres dans la section Network Information de la page des détails de l'instance, disponible dans la console Hologres.
database
No default value
Configurez ce paramètre ou le paramètre JDBCURL.
Nom de la base de données Hologres contenant la table de destination.
jdbcurl
No default value
Configurez uniquement ce paramètre ou les paramètres ENDPOINT et DATABASE.
JDBC URL de votre instance Hologres.
copy_write_mode
true
No
Indique si l'écriture des données doit se faire en mode copy fixe. Le copy fixe est une nouvelle fonctionnalité prise en charge par Hologres V1.3. Dans ce mode, les données sont écrites en flux continu plutôt que par lots. Par conséquent, l'écriture en mode copy fixe offre un débit plus élevé et une latence plus faible, tout en consommant moins de ressources mémoire côté client que l'écriture via une instruction INSERT.
RemarquePour utiliser le mode copy fixe, la version du connecteur doit être supérieure ou égale à V1.3.0 et la version du moteur Hologres doit être supérieure ou égale à V1.3.34.
copy_write_format
false
No
Indique s'il faut vérifier la présence de données incorrectes (dirty data). Ce paramètre n'est effectif que si COPY_WRITE_MODE est défini sur true. Si vous activez cette option et que des données incorrectes sont générées, le système peut identifier la ligne dont l'écriture a échoué.
RemarqueLa vérification des données incorrectes affecte négativement les performances d'écriture. Il est recommandé d'activer ce paramètre uniquement lors des phases de dépannage.
bulk_load
true
No
Indique si l'écriture des données dans Hologres doit se faire en mode copy par lots. En mode copy fixe, les données sont écrites en flux continu.
RemarqueDans Hologres V2.1, les performances d'écriture vers des tables sans clé primaire sont optimisées. L'opération d'écriture par lots sur une table sans clé primaire n'acquiert pas de verrou de table, mais un verrou de ligne. Ainsi, les écritures par lots peuvent s'exécuter en parallèle avec les opérations utilisant des plans fixes, ce qui améliore l'efficacité et le parallélisme du traitement des données.
Si la version du connecteur est supérieure ou égale à V1.4.0, la version du moteur Hologres doit être supérieure ou égale à V2.1.0.
max_cell_buffer_size
20971520 (20 MB)
No
Longueur maximale d'un champ lorsque COPY_WRITE_MODE est défini sur true.
copy_write_dirty_data_check
false
No
Indique s'il faut vérifier la présence de données incorrectes. Si vous activez cette option et que des données incorrectes sont générées, le système peut identifier la ligne dont l'écriture a échoué. La vérification des données incorrectes affecte négativement les performances d'écriture. Il est recommandé d'activer ce paramètre uniquement lors des phases de dépannage.
RemarqueCe paramètre n'est effectif que si COPY_WRITE_MODE est défini sur true.
copy_write_direct_connect
true for scenarios that allow direct connections
No
Ce paramètre n'est effectif que si COPY_WRITE_MODE est défini sur true. Le volume de données pouvant être écrit en mode copy dépend du débit de l'endpoint VPC. Le système vérifie si l'environnement permet une connexion directe au nœud FE Hologres lors de l'écriture en mode copy. Les connexions directes sont utilisées par défaut si l'environnement le permet. Si ce paramètre est défini sur false, les connexions directes ne sont pas utilisées.
input_data_schema_ddl
No default value
Ce paramètre est obligatoire pour Spark 3.X. Configurez la valeur au format
<your_DataFrame>.schema.toDDL.Instruction DDL pour le DataFrame dans Spark.
write_mode
INSERT_OR_REPLACE
No
Politique de gestion des conflits de clé primaire. Ce paramètre est requis si la table de destination possède une clé primaire. Valeurs possibles :
INSERT_OR_IGNORE : ignore les données à écrire en cas de conflit de clé primaire.
INSERT_OR_UPDATE : met à jour les colonnes concernées dans la table de destination en cas de conflit de clé primaire.
INSERT_OR_REPLACE : met à jour toutes les colonnes de la table de destination en cas de conflit de clé primaire.
write_batch_size
512
No
Nombre maximal de requêtes autorisées par lot dans un thread pour l'écriture des données. Une fois les conflits gérés selon le paramètre write_mode, si le nombre total de requêtes PUT atteint la limite spécifiée par le paramètre write_batch_size, les données sont soumises par lot.
write_batch_byte_size
2 MB
No
Nombre maximal d'octets autorisés par lot dans un thread pour l'écriture des données. Une fois les conflits gérés selon le paramètre WRITE_MODE, si le nombre total d'octets des requêtes PUT atteint la limite spécifiée par le paramètre WRITE_BATCH_BYTE_SIZE, les données sont soumises par lot.
write_max_interval_ms
10000 ms
No
Intervalle de soumission des données par lot.
write_fail_strategy
TYR_ONE_BY_ONE
No
Politique de gestion des échecs de soumission. Si un lot ne peut pas être soumis, Holo Client tente de soumettre les entrées de données une par une, dans l'ordre spécifié. Si une entrée ne peut pas être soumise, Holo Client renvoie un message d'erreur contenant les informations relatives à cette entrée.
write_thread_size
1
No
Nombre de threads parallèles utilisés pour l'écriture des données. Chaque thread occupe une connexion.
Le nombre total de connexions occupées par un job Spark varie selon le parallélisme Spark. Le nombre total de connexions peut être calculé à l'aide de la formule suivante :
Total number of connections = Value of spark.default.parallelism × Value of WRITE_THREAD_SIZE.dynamic_partition
false
No
Indique s'il faut créer automatiquement une partition si les données sont écrites dans une table parente non partitionnée. Valeurs possibles : true et false. true : une partition est automatiquement créée si les données sont écrites dans une table parente non partitionnée.
retry_count
3
No
Nombre maximal de tentatives autorisées pour l'écriture et la lecture des données en cas d'échec de connexion.
retry_sleep_init_ms
1000 ms
No
La durée totale des tentatives pour une requête est calculée à l'aide de la formule suivante : retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
retry_sleep_step_ms
10*1000 ms
No
La durée totale des tentatives pour une requête est calculée à l'aide de la formule suivante : retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
connection_max_idle_ms
60000 ms
No
Délai d'inactivité pour les connexions utilisées en lecture et en écriture. Si une connexion reste inactive au-delà du délai spécifié, Holo Client la libère automatiquement.
fixed_connection_mode
false
No
Indique s'il faut utiliser des connexions fixes. Dans un mode copy non fixe, tel que le mode INSERT, les écritures de données et les requêtes ponctuelles n'occupent pas de connexions.
RemarqueLa fonctionnalité de connexion fixe est en version bêta et n'est disponible que si la version du connecteur est supérieure ou égale à V1.2.0 et la version du moteur Hologres est supérieure ou égale à V1.3.0.
scan_batch_size
256
No
Nombre de lignes analysées à chaque lecture des données depuis Hologres.
scan_timeout_seconds
60
No
Délai d'expiration de l'opération de scan lors de la lecture des données depuis Hologres. Unité : secondes.
scan_parallelism
10
No
Nombre de shards utilisés pour lire les données depuis Hologres. La valeur maximale correspond au nombre de shards de la table Hologres. Lors de l'exécution du job, les shards sont attribués aux tâches Spark pour la lecture des données.
-
Mappages des types de données
Le tableau suivant décrit les mappages des types de données entre Spark et Hologres.
|**Spark data type**
|
**Hologres data type**
| | --- | --- | |
ShortType
|
SMALLINT
| |
IntegerType
|
INT
| |
LongType
|
BIGINT
| |
StringType
|
TEXT, JSONB, and JSON
| |
DecimalType
|
NUMERIC(38, 18)
| |
BooleanType
|
BOOL
| |
DoubleType
|
DOUBLE PRECISION
| |
FloatType
|
FLOAT
| |
TimestampType
|
TIMESTAMPTZ
| |
DateType
|
DATE
| |
BinaryType
|
BYTEA and ROARINGBITMAP
| |
ArrayType(IntegerType)
|
int4[]
| |
ArrayType(LongType)
|
int8[]
| |
ArrayType(FloatType
|
float4[]
| |
ArrayType(DoubleType)
|
float8[]
| |
ArrayType(BooleanType)
|
boolean[]
| |
ArrayType(StringType)
|
text[]
|