Cette rubrique explique comment configurer le réseau, la liste d'autorisation et les autorisations de compte requis pour la tâche de synchronisation des données.
Prérequis
Avant de configurer les sources de données, assurez-vous d'avoir effectué les préparatifs suivants :
Vous avez acheté les sources de données MySQL (source) et Hologres (destination).
Vous avez acheté et configuré un groupe de ressources exclusif pour Data Integration. Pour plus d'informations, consultez Planification et configuration des ressources.
-
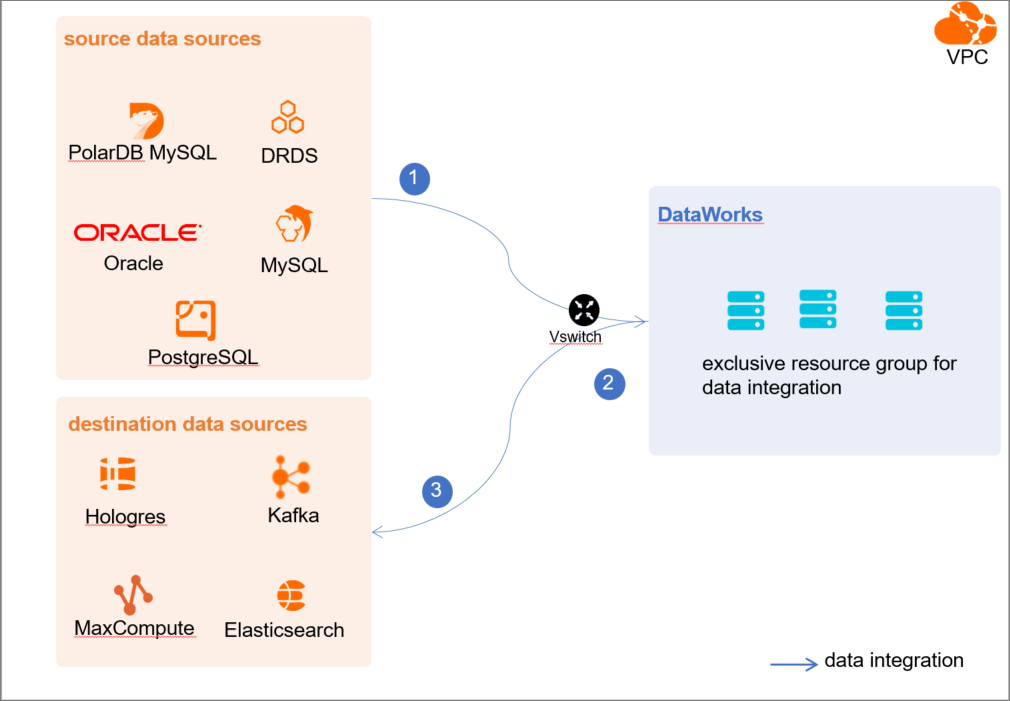
Vous avez établi une connexion réseau entre vos sources de données et le groupe de ressources exclusif pour Data Integration. Une fois le réseau connecté, suivez les instructions de cette rubrique pour configurer les paramètres d'accès au réseau, tels que les vSwitches et les listes d'autorisation.
Si les sources de données et le groupe de ressources exclusif pour Data Integration se trouvent dans le même VPC et la même région, ils sont connectés automatiquement.
Si les sources de données et le groupe de ressources exclusif pour Data Integration se trouvent dans des environnements réseau différents, vous devez les connecter à l'aide d'une passerelle VPN ou d'autres méthodes.
Contexte
Pour synchroniser les données, assurez-vous que les sources de données et le groupe de ressources exclusif pour Data Integration dans DataWorks sont connectés et que les autorisations de compte nécessaires sont accordées.
-
Liste d'autorisation
L'exemple suivant suppose un environnement VPC. Vous devez ajouter le bloc CIDR du groupe de ressources exclusif pour Data Integration à la liste d'autorisation. Cela garantit que le groupe de ressources peut accéder à la source de données.
-
Autorisations de compte
Créez un compte capable d'accéder à la source de données. Data Integration utilise ce compte pour accéder à la source de données et extraire et écrire des données pendant le processus de synchronisation.
-
Autres restrictions d'accès
Si votre source de données est MySQL, vous devez activer la journalisation binaire (binlog). Un binlog est un journal qui enregistre toutes les modifications apportées aux structures des tables de base de données, telles que
CREATEetALTER, ainsi que les modifications de données, telles queINSERT,UPDATEetDELETE. Vous pouvez utiliser le binlog pour afficher l'historique des modifications de la base de données, effectuer des sauvegardes et des restaurations incrémentielles, et répliquer les données d'une base de données principale vers un réplica.Le binlog prend en charge les formats suivants :
Statement : Réplication basée sur les instructions. Le binlog enregistre chaque instruction SQL qui modifie les données.
Row : Réplication basée sur les lignes. Le binlog ne sauvegarde pas le contexte des instructions SQL, mais enregistre uniquement les détails des lignes modifiées.
Mixed : Réplication en mode mixte. Il s'agit d'une combinaison des formats Statement et Row. Généralement, le format Statement est utilisé pour la plupart des modifications, telles que les fonctions. Si une opération ne peut pas être répliquée avec le format Statement, le format Row est utilisé. MySQL détermine automatiquement le format à utiliser pour chaque instruction SQL exécutée.
Limites
DataWorks implémente la synchronisation en temps réel des données MySQL en s'abonnant à MySQL en temps réel. Cette fonctionnalité prend actuellement en charge uniquement les sources de données MySQL qui sont des instances RDS for MySQL
5.xou8.x. Ne configurez pas une instance PolarDB-X en tant que source de données MySQL. Configurez-la plutôt en tant que source de données PolarDB-X. Pour plus d'informations, consultez Configuration d'une source de données PolarDB-X.XA ROLLBACK n'est pas pris en charge. Pour les données de transaction préparées avec XA PREPARE, la synchronisation en temps réel synchronise les données vers la destination. Si un XA ROLLBACK se produit ultérieurement, la synchronisation en temps réel n'annule pas les données précédemment synchronisées sur la destination. Pour gérer les scénarios XA ROLLBACK, vous devez supprimer manuellement les tables concernées de la tâche de synchronisation en temps réel, les rajouter, puis effectuer une initialisation complète des données et une synchronisation en temps réel incrémentielle à nouveau.
Si vous ajoutez une instance MySQL appartenant à un autre compte Alibaba Cloud en tant que source de données, les tâches de synchronisation ultérieures utilisant cette source de données ne peuvent s'exécuter que sur un groupe de ressources exclusif pour Data Integration. Un groupe de ressources partagé pour Data Integration ne peut pas accéder à cette source de données.
Procédure
-
Configurez la liste d'autorisation.
Ajoutez le bloc CIDR du VPC du groupe de ressources exclusif pour Data Integration à la liste d'autorisation de la base de données MySQL.
-
Enregistrez les informations réseau du groupe de ressources.
Connectez-vous à la console DataWorks.
Dans le volet de navigation de gauche, cliquez sur Resource groups.
Sous l'onglet Exclusive resource groups, recherchez le groupe de ressources Data Integration cible et cliquez sur View Information.
Dans la boîte de dialogue, copiez l' EIP address et le CIDR block.
Sous l'onglet Exclusive resource groups, recherchez le groupe de ressources Data Integration cible et cliquez sur Network Settings.
Sous l'onglet VPC binding, affichez et enregistrez le vSwitch CIDR block.
Ajoutez l'adresse EIP et le bloc CIDR à la liste d'autorisation.
-
-
Créez un compte et accordez des autorisations.
Créez un compte utilisateur de base de données. Le compte doit disposer des privilèges
SELECT, REPLICATION SLAVE, REPLICATION CLIENT
.
-
Créez un compte.
-
Accordez des privilèges.
Exécutez la commande suivante pour accorder des privilèges au compte, ou accordez le privilège
SUPER
. Dans les instructions suivantes, remplacez
« Compte de synchronisation »
par le compte que vous avez créé.
-- CREATE USER 'Synchronization account'@'%' IDENTIFIED BY 'Password'; -- Creates a synchronization account and set a password. This allows the account to log on to the database from any host. % indicates any host.
GRANT SELECT, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO 'Synchronization account'@'%'; -- Grants the SELECT, REPLICATION SLAVE, and REPLICATION CLIENT privileges to the synchronization account.
.
accorde au compte de synchronisation les privilèges précédents sur toutes les tables de toutes les bases de données. Vous pouvez également accorder les privilèges précédents sur des tables spécifiques dans une base de données spécifique. Par exemple, pour accorder au compte de synchronisation les privilèges précédents sur la table
test
.
user
, utilisez l'instruction suivante :
GRANT SELECT, REPLICATION CLIENT ON test.user TO 'Synchronization account'@'%';
.
RemarqueLe privilège
REPLICATION SLAVE
est un privilège global. Vous ne pouvez pas accorder ce privilège sur une table spécifique dans une base de données spécifique.
-
-
Activez le binlog MySQL.
Vérifiez si le binlog est activé et interrogez le format du binlog :
-
Exécutez l'instruction suivante pour vérifier si le binlog est activé.
show variables like "log_bin";Une valeur de retour ON indique que le binlog est activé.
-
Si vous utilisez une base de données réplica pour synchroniser les données, vous pouvez également exécuter l'instruction suivante pour vérifier si le binlog est activé.
show variables like "log_slave_updates";Une valeur de retour ON indique que le binlog est activé pour la base de données réplica.
Si le binlog n'est pas activé, suivez les instructions de la
documentation officielle MySQL
pour l'activer.
Exécutez l'instruction suivante pour interroger le format du binlog.
show variables like "binlog_format";Description des résultats renvoyés :
Une valeur de retour ROW indique le format ROW.
Une valeur de retour STATEMENT indique le format STATEMENT.
Une valeur de retour MIXED indique le format MIXED.
-
Étapes suivantes
Après avoir effectué ces étapes, les sources de données source et destination sont connectées via le groupe de ressources exclusif pour Data Integration, et les autorisations d'accès nécessaires sont accordées. Vous pouvez ensuite ajouter les sources de données source et destination à la liste des sources de données DataWorks et les associer à une solution de synchronisation des données lors de sa création.
Pour plus d'informations sur l'ajout d'une source de données, consultez Ajout d'une source de données.