La configuration des fonctionnalités est une étape clé de la mise en place de votre solution de recommandation. Vous définissez les fonctionnalités via l'interface utilisateur, ce qui génère automatiquement le code SQL MaxCompute et Flink nécessaire. Ce processus produit des fonctionnalités statistiques courantes, des fonctionnalités de séquence, des fonctionnalités MinMax et des fonctionnalités clé-valeur, puis les exporte sous forme d'échantillons destinés aux modèles de rappel vectoriel, de pré-classement et de classement fin.
1. Configuration des périodes courantes et des comportements
Périodes courantes : Définissez des périodes statistiques personnalisées, telles que court, moyen et long terme. Évitez de multiplier les périodes, car cela génère un nombre excessif de fonctionnalités. Par exemple, avec 200 fonctionnalités par période, trois périodes produisent 600 fonctionnalités, tandis que six périodes en produisent 1 200.
Comportements d'intérêt : Il s'agit des valeurs énumérées de comportement issues de votre table de journaux de comportement. Limitez-vous à cinq comportements maximum afin d'éviter de créer trop de fonctionnalités. Si vous disposez de nombreux types de comportements, fusionnez ceux qui sont moins importants ou sémantiquement similaires lors de la préparation des données dans les tables amont. L'ordre des comportements est important : listez-les selon la séquence dans laquelle ils se produisent, par exemple « exposition, clic, like » (correspondant aux valeurs
expr,clicketpraisedu champevent). Un ordre incorrect affecte la génération des fonctionnalités de ratio et nécessite une correction manuelle.
Sur la page de configuration, définissez les périodes statistiques dans la section « Common periods » et spécifiez les valeurs énumérées de comportement dans la section « Behaviors of interest ». Cliquez sur le bouton Generate Feature en bas de la page pour dériver automatiquement les fonctionnalités statistiques.
2. Fonctionnalités dérivées de base
Par exemple, côté utilisateur, les fonctionnalités d'attribut de base peuvent inclure à l'origine des champs tels que gender, city, follow_cnt, register_time et age. Ajoutez une fonctionnalité de calcul du temps écoulé, sélectionnez register_time comme champ associé et générez la fonctionnalité nommée user_register_time. Ensuite, ajoutez une fonctionnalité de binning de fonctionnalité, sélectionnez user_register_time comme champ associé, définissez le point de scission sur 3 et générez la fonctionnalité nommée user_register_time_bin.
Certaines fonctionnalités d'attribut de base sont dérivées automatiquement à partir de vos configurations de tables amont, mais vous pouvez cliquer sur Add pour en créer davantage. Notez que vous pouvez dériver des fonctionnalités d'attribut de base côté utilisateur, côté élément et à partir de la table de journaux de comportement.
Résolution d'adresse IP : Dérive des fonctionnalités à partir d'un champ IP configuré dans une table amont. Selon votre configuration, le système peut résoudre une adresse IP en sa province, sa ville et son pays. Notez que les résultats de la résolution peuvent être inexacts.
Calcul du temps écoulé : Calcule le nombre de jours écoulés depuis la date d'inscription d'un utilisateur ou d'un élément.
Binning de fonctionnalité : Divise un champ numérique en bins en fonction de points de scission spécifiés, le convertissant ainsi en une fonctionnalité catégorielle.
Combinaison de fonctionnalités : Combine plusieurs champs catégoriels, tels que des combinaisons catégorie-catégorie, catégorie-tag ou tag-tag. Les champs combinés doivent appartenir à la même table et se trouver entièrement soit côté utilisateur, soit côté élément.
Pour la table de journaux de comportement, l'extraction de l'heure de la journée et l'extraction du jour de la semaine sont toutes deux dérivées du champ event_time, générant respectivement les fonctionnalités nommées day_h et week_day.
Pour la table de journaux de comportement, ces deux dérivations sont également disponibles :
Extraction de l'heure de la journée : Extrait l'heure de la journée à partir d'une entrée de journal.
Extraction du jour de la semaine : Extrait le jour de la semaine à partir d'une entrée de journal.
Après avoir ajouté des fonctionnalités dérivées de base, cliquez sur Save dans le coin supérieur droit pour appliquer vos modifications.
3. Fonctionnalités de préférence comportementale
Le système dérive automatiquement diverses fonctionnalités statistiques pour le côté utilisateur et le côté élément, en utilisant les ID utilisateur et les ID élément comme clés primaires pour l'agrégation. Les six types de statistiques suivants sont disponibles :
Statistiques de comportement
Calcul du taux de conversion
Nombre de comportements pour les attributs principaux
Ratio de comportements pour les attributs principaux
Fonctionnalités numériques préférées
Fonctionnalité de combinaison catégorie-numérique principale
Pour supprimer les fonctionnalités inutiles, cliquez sur Delete, ou sur Edit pour supprimer un attribut spécifique. Cliquez sur Add dans le coin inférieur droit pour ajouter d'autres fonctionnalités. Les sections suivantes décrivent ces types de fonctionnalités statistiques en détail.
Statistiques de comportement
Cette fonctionnalité compte le nombre de fois qu'un utilisateur effectue des comportements spécifiques (tels que expr, click ou praise) au cours de périodes définies (par exemple, 3, 7 et 15 jours). Si un ID de déduplication est fourni, le comptage s'effectue après déduplication par cet ID. Si un scénario est configuré, seuls les comportements liés à ce scénario sont comptés. Avec 3 périodes statistiques et 3 comportements, cet exemple génère 9 fonctionnalités (3 périodes × 3 comportements = 9).
-
Calcul du taux de conversion
Dans cet exemple, 3 périodes statistiques (3, 7 et 15 jours) et 2 formules de taux de conversion (
click/expretpraise/click) sont configurées.Cette fonctionnalité calcule le taux de conversion entre les comportements. Elle calcule le ratio du nombre d'un comportement par rapport à un autre sur des périodes spécifiques, par exemple en divisant le nombre de
clickpar le nombre deexpr, ou le nombre depraisepar le nombre declick. Vous pouvez modifier, ajouter ou supprimer ces formules. Si un scénario est configuré, seuls les comportements de ce scénario sont inclus. Cette configuration d'exemple génère 6 fonctionnalités (nombre de périodes statistiques × nombre de formules de taux de conversion). -
Nombre de comportements pour les attributs principaux
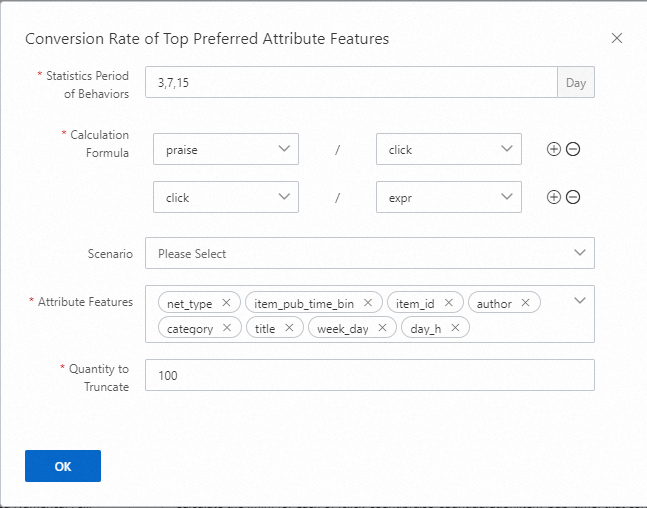
Cette fonctionnalité compte combien de fois un utilisateur effectue un comportement (comme
expr,clickoupraise) pour chaque valeur d'une fonctionnalité d'attribut catégorielle ou multivaluée au cours d'une période donnée (par exemple, 3, 7 ou 15 jours). Le résultat est une fonctionnalité clé-valeur. Par exemple, en utilisant la catégorieday_het le comportementclick, une fonctionnalité générée telle que « 12:27.0,8:26.0,1:1.0 » signifie qu'au cours de la période actuelle, l'utilisateur a cliqué 27 fois pendant l'heure 12, 26 fois pendant l'heure 8 et 1 fois pendant l'heure 1. Si un scénario est configuré, seules les données de ce scénario sont utilisées. Si le nombre de clés devient trop élevé, il est tronqué à 100 par défaut. Cette configuration d'exemple génère 54 fonctionnalités (nombre de périodes statistiques × nombre de comportements × nombre de fonctionnalités d'attribut). -
Ratio de comportements pour les attributs principaux
Cette fonctionnalité calcule le ratio de comportements, tels que
click/expr(taux de clics, CTR) oupraise/click, pour chaque valeur d'une fonctionnalité d'attribut catégorielle ou multivaluée au cours d'une période donnée (par exemple, 3, 7 ou 15 jours). Le résultat est une fonctionnalité clé-valeur. Par exemple, aveccatecomme catégorie etclick/exprcomme formule, une fonctionnalité générée telle que « 12:0.27,8:0.26 » signifie que le CTR de l'utilisateur pour la catégorie 12 est de 0,27 et de 0,26 pour la catégorie 8 au cours de la période actuelle. Si un scénario est configuré, seules les données de ce scénario sont utilisées. Si le nombre de clés est trop élevé, il est tronqué à 100 par défaut. Cette configuration d'exemple génère 36 fonctionnalités : 3 périodes statistiques (3, 7, 15 jours) × 2 formules de taux de conversion (click/expr,praise/click) × 6 fonctionnalités d'attribut. -
Fonctionnalités numériques préférées
Dans cet exemple, les 4 fonctionnalités numériques sélectionnées sont
click_count,praise_count,durationetitem_pub_time.Cette fonctionnalité agrège un attribut numérique sélectionné en fonction d'un comportement spécifique (comme
expr,clickoupraise) et d'une logique de calcul (telle que la somme, le maximum, le minimum ou la moyenne) au cours d'une période donnée (par exemple, 3, 7 ou 15 jours). Si un scénario est configuré, seules les données de ce scénario sont utilisées. Cette configuration d'exemple génère 36 fonctionnalités (nombre de périodes statistiques × nombre de comportements × nombre de fonctionnalités numériques). -
Fonctionnalité de combinaison catégorie-numérique principale
Dans cet exemple, les fonctionnalités catégorielles pour la combinaison sont
category,day_hetweek_day. La fonctionnalité numérique estplaytimeet la quantité de troncature est définie sur 100.Cette fonctionnalité calcule la préférence d'un utilisateur pour une valeur numérique au sein d'une catégorie spécifique. Elle agrège une valeur numérique en fonction d'une logique de calcul (telle que la somme, le maximum, le minimum ou la moyenne) pour chaque comportement (comme
expr,clickoupraise) au cours d'une période donnée (par exemple, 3, 7 ou 15 jours). Si un scénario est configuré, seules les données de ce scénario sont utilisées. Cette configuration d'exemple génère 27 fonctionnalités (nombre de périodes statistiques × nombre de comportements × nombre de fonctionnalités catégorielles dans la combinaison).
4. Fonctionnalité de séquence
Les fonctionnalités de séquence ne peuvent être configurées que côté utilisateur. Comme les fonctionnalités de séquence sont souvent indisponibles au début d'un projet de recommandation, vous pouvez les simuler à partir des données de comportement historiques. Cela accélère les expériences et le déploiement en réduisant le temps nécessaire pour collecter les fonctionnalités de séquence en ligne. L'événement simulé est généralement une exposition (expr). La leakage prevention period exclut les comportements survenus au cours des N dernières secondes de la séquence actuelle. Ceci est crucial car le reflux des journaux lors de l'inférence peut provoquer des retards de données. Si la simulation est trop proche du temps réel, elle peut entraîner une fuite de données lors de l'entraînement. Le sequence feature separator est le délimiteur entre les éléments d'une séquence, tandis que le sub-feature separator est le délimiteur entre les sous-fonctionnalités d'un seul élément.
Dans la configuration générale, l'événement simulé est par défaut expr, le séparateur de fonctionnalité de séquence est par défaut ; et le séparateur de sous-fonctionnalité est par défaut #. Le tableau ci-dessous affiche les règles de fonctionnalité de séquence configurées, avec des colonnes pour Primary key, Category, Calculation logic et Operations. Cliquez sur Add pour créer une nouvelle règle, ou utilisez Edit et Delete pour gérer les règles existantes.
Par exemple, définissez la période de comportement sur 30 jours, sélectionnez expr pour Behavior, sélectionnez item_id pour Deduplication ID, et sélectionnez category, click_count, praise_count et duration pour Sub-feature. Définissez la quantité de troncature sur 100.
Période de comportement : Nombre de jours récents à partir desquels collecter les comportements. Si plusieurs séquences sont configurées, la période la plus longue est prioritaire.
Comportement : Type de comportement à collecter dans la séquence.
Scénario : Scénario permettant de filtrer les comportements. Si aucune sélection n'est effectuée, les comportements de tous les scénarios sont collectés.
ID de déduplication : Sous-fonctionnalité utilisée pour la déduplication au sein de la séquence. Pour un ID donné, seule la dernière occurrence du comportement est conservée.
Sous-fonctionnalité : Sous-fonctionnalités qui constituent un élément dans la séquence. Il s'agit généralement de fonctionnalités non statistiques côté élément, y compris les fonctionnalités catégorielles, catégorielles multivaluées et numériques.
Quantité de troncature : Nombre maximal d'éléments à conserver dans la séquence.
5. Fonctionnalité en temps réel
Les fonctionnalités statistiques en temps réel peuvent être créées avec soit les ID utilisateur, soit les ID élément comme clé primaire. La leakage prevention period sert le même objectif que pour les fonctionnalités de séquence : elle empêche l'inclusion des comportements des N dernières secondes dans le comptage. Ce paramètre est nécessaire car les journaux de comportement subissent un délai lors de leur transmission depuis le client, via le middleware orienté message, jusqu'au service de stockage en ligne. Sans ce paramètre, les statistiques en ligne peuvent être inexactes. Pour les fonctionnalités en temps réel, la période statistique est mesurée en secondes. Les quatre types statistiques suivants sont pris en charge :
Statistiques de comportement
Calcul du taux de conversion
Nombre de comportements pour les attributs principaux
Ratio de comportements pour les attributs principaux
Ces quatre types ont la même signification que leurs homologues dans la section des fonctionnalités de préférence comportementale ; seule l'unité de période statistique diffère.
Dans l'exemple de configuration, la période de prévention des fuites est définie sur 10 secondes. Avec user_id comme clé primaire, les statistiques sont calculées pour les comportements click et praise dans une fenêtre de [1800, 3600] secondes. La valeur Top-N est définie sur 100 et les attributs de préférence sont category et duration_bin. Utilisez les actions Edit et Delete dans la colonne des opérations pour gérer les lignes. En bas, cliquez sur Add pour créer une nouvelle configuration ou sur View Details pour plus d'informations.
6. Fonctionnalité d'agrégation
Les fonctionnalités d'agrégation peuvent être configurées à la fois côté utilisateur et côté élément. Vous devez sélectionner une ou plusieurs conditions d'agrégation. Seules les fonctionnalités catégorielles peuvent être utilisées comme conditions d'agrégation.
Le système calcule les fonctionnalités en fonction des conditions d'agrégation actuelles. Les types statistiques disponibles sont les mêmes que ceux des fonctionnalités de préférence comportementale et ont la même signification. Par exemple, la première ligne de la configuration signifie que le nombre total d'événements click, praise et exposure est compté pour différentes combinaisons de genre et d'âge. Prenons l'exemple du rouge à lèvres : il est plus susceptible d'être cliqué par les utilisatrices, il est donc utile d'analyser les statistiques de vente des articles par genre.
Dans le tableau de configuration, la clé primaire est User ID:gender_age, et chaque type statistique est calculé dans une fenêtre de [3, 10] jours en fonction de la dimension gender_age. Gérez la configuration à l'aide des liens Add, View Details, Add aggregation condition et Delete aggregation condition en bas de la page.