Para detectar anomalías, utilice una función de predicción y detección de anomalías que permita predecir la curva de una serie temporal e identificar los valores Ksigma y los cuantiles de los errores entre la curva predicha y la curva real.
Lista de funciones
|
Función |
Descripción |
|
Utiliza parámetros predeterminados para modelar datos de series temporales y realiza predicciones simples de series temporales y detección de anomalías. |
|
|
Emplea un modelo autorregresivo (AR) para modelar datos de series temporales y ejecuta predicciones simples de series temporales y detección de anomalías. |
|
|
Usa un modelo de media móvil autorregresiva (ARMA) para modelar datos de series temporales y lleva a cabo predicciones simples de series temporales y detección de anomalías. |
|
|
Aplica un modelo de media móvil integrada autorregresiva (ARIMA) para modelar datos de series temporales y efectúa predicciones simples de series temporales y detección de anomalías. |
|
|
Predice con precisión la tendencia de una curva de serie temporal periódica. Escenario: esta función es adecuada para predecir datos de medición, tráfico de red, datos financieros y distintos tipos de datos empresariales que siguen reglas específicas. |
|
|
Filtra las anomalías detectadas durante el análisis de varias curvas de series temporales según el modo de anomalía personalizado. Esta función permite identificar rápidamente las curvas anómalas. |
ts_predicate_simple
Formato de la función:
select ts_predicate_simple(x, y, nPred, isSmooth) A continuación se describen los parámetros del formato de la función.
|
Parámetro |
Descripción |
Valor |
|
x |
La secuencia temporal. Los puntos en el tiempo se ordenan de forma ascendente a lo largo del eje horizontal. |
Cada punto en el tiempo es una marca de tiempo Unix. Unidad: segundos. |
|
y |
La secuencia de datos numéricos correspondiente a cada punto en el tiempo especificado. |
N/A. |
|
nPred |
El número de puntos para la predicción. |
El valor es de tipo de datos long y debe ser igual o mayor que 1. |
|
isSmooth |
Especifica si se filtran los datos sin procesar. |
El valor es de tipo de datos booleano. El valor predeterminado es true, lo que indica que los datos sin procesar se filtran. |
Ejemplo:
-
La sentencia de consulta es la siguiente:
* | select ts_predicate_simple(stamp, value, 6) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp) Resultado de salida
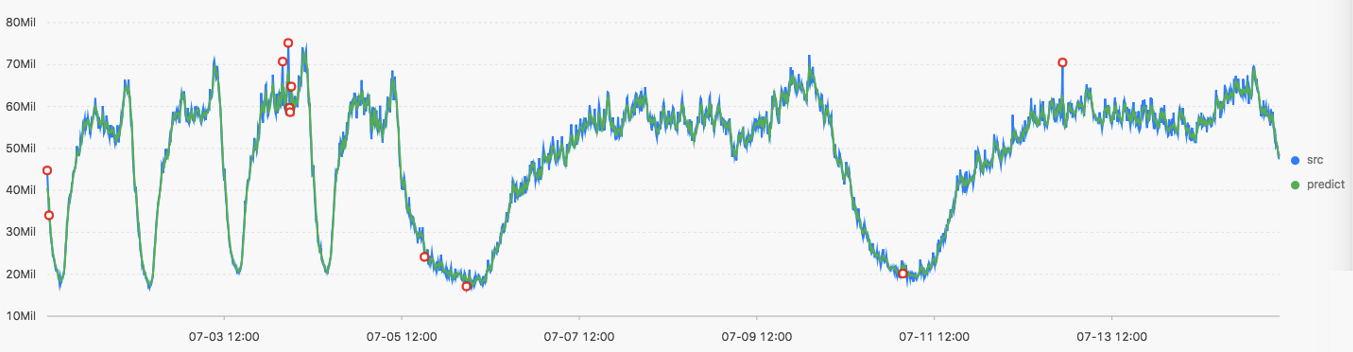
A continuación se describen los elementos de visualización.
Elemento de visualización | Descripción | |
Eje horizontal | unixtime | La marca de tiempo Unix de los datos. Unidad: segundos. |
Eje vertical | src | Los datos sin procesar. |
predict | Los datos generados después de realizar la operación de filtrado. | |
upper | El límite superior del intervalo de confianza. El nivel de confianza es 0.85 y no se puede modificar. | |
lower | El límite inferior del intervalo de confianza. El nivel de confianza es 0.85 y no se puede modificar. | |
anomaly_prob | La probabilidad de que el punto sea una anomalía. Valores válidos: [0, 1]. | |
ts_predicate_ar
Formato de la función:
select ts_predicate_ar(x, y, p, nPred, isSmooth) A continuación se describen los parámetros del formato de la función.
|
Parámetro |
Descripción |
Valor |
|
x |
La secuencia temporal. Los puntos en el tiempo se ordenan de forma ascendente a lo largo del eje horizontal. |
Cada punto en el tiempo es una marca de tiempo Unix. Unidad: segundos. |
|
y |
La secuencia de datos numéricos correspondiente a cada punto en el tiempo especificado. |
N/A. |
|
p |
El orden del modelo AR. |
El valor es de tipo de datos long. Valores válidos: 2, 3, 4, 5, 6, 7 y 8. |
|
nPred |
El número de puntos para la predicción. |
El valor es de tipo de datos long. Valores válidos: [1, 5 × p]. |
|
isSmooth |
Especifica si se filtran los datos sin procesar. |
El valor es de tipo de datos booleano. El valor predeterminado es true, lo que indica que los datos sin procesar se filtran. |
Un ejemplo de la sentencia de consulta es el siguiente:
* | select ts_predicate_ar(stamp, value, 3, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp)El resultado de salida es similar al de la función ts_predicate_simple. Para obtener más información, consulte el resultado de salida de la función ts_predicate_simple.
ts_predicate_arma
Formato de la función:
select ts_predicate_arma(x, y, p, q, nPred, isSmooth) A continuación se describen los parámetros del formato de la función.
|
Parámetro |
Descripción |
Valor |
|
x |
La secuencia temporal. Los puntos en el tiempo se ordenan de forma ascendente a lo largo del eje horizontal. |
Cada punto en el tiempo es una marca de tiempo Unix. Unidad: segundos. |
|
y |
La secuencia de datos numéricos correspondiente a cada punto en el tiempo especificado. |
N/A. |
|
p |
El orden del modelo AR. |
El valor es de tipo de datos long. Valores válidos: [2, 100]. |
|
q |
El orden del modelo ARMA. |
El valor es de tipo de datos long. Valores válidos: 2, 3, 4, 5, 6, 7 y 8. |
|
nPred |
El número de puntos para la predicción. |
El valor es de tipo de datos long. Valores válidos: [1, 5 × p]. |
|
isSmooth |
Especifica si se filtran los datos sin procesar. |
El valor es de tipo de datos booleano. El valor predeterminado es true, lo que indica que los datos sin procesar se filtran. |
Un ejemplo de la sentencia de consulta es el siguiente:
* | select ts_predicate_arma(stamp, value, 3, 2, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp) El resultado de salida es similar al de la función ts_predicate_simple. Para obtener más información, consulte el resultado de salida de la función ts_predicate_simple.
ts_predicate_arima
Formato de la función:
select ts_predicate_arima(x, y, p, d, q, nPred, isSmooth) A continuación se describen los parámetros del formato de la función.
|
Parámetro |
Descripción |
Valor |
|
x |
La secuencia temporal. Los puntos en el tiempo se ordenan de forma ascendente a lo largo del eje horizontal. |
Cada punto en el tiempo es una marca de tiempo Unix. Unidad: segundos. |
|
y |
La secuencia de datos numéricos correspondiente a cada punto en el tiempo especificado. |
N/A. |
|
p |
El orden del modelo AR. |
El valor es de tipo de datos long. Valores válidos: 2, 3, 4, 5, 6, 7 y 8. |
|
d |
El orden del modelo ARIMA. |
El valor es de tipo de datos long. Valores válidos: [1, 3]. |
|
q |
El orden del modelo ARMA. |
El valor es de tipo de datos long. Valores válidos: 2, 3, 4, 5, 6, 7 y 8. |
|
nPred |
El número de puntos para la predicción. |
El valor es de tipo de datos long. Valores válidos: [1, 5 × p]. |
|
isSmooth |
Especifica si se filtran los datos sin procesar. |
El valor es de tipo de datos booleano. El valor predeterminado es true, lo que indica que los datos sin procesar se filtran. |
Un ejemplo de la sentencia de consulta es el siguiente:
* | select ts_predicate_arima(stamp, value, 3, 1, 2, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp)El resultado de salida es similar al de la función ts_predicate_simple. Para obtener más información, consulte el resultado de salida de la función ts_predicate_simple.
ts_regression_predict
Formato de la función:
select ts_regression_predict(x, y, nPred, algotype,processType)A continuación se describen los parámetros del formato de la función.
Parámetro | Descripción | Valor |
x | La secuencia temporal. Los puntos en el tiempo se ordenan de forma ascendente a lo largo del eje horizontal. | Cada punto en el tiempo es una marca de tiempo Unix. Unidad: segundos. |
y | La secuencia de datos numéricos correspondiente a cada punto en el tiempo especificado. | N/A. |
nPred | El número de puntos para la predicción. | El valor es de tipo de datos long. Valores válidos: [1, 500]. |
algotype | El tipo de algoritmo para la predicción. | Valores válidos:
|
processType | Especifica si se preprocesan los datos. | Valores válidos:
|
Ejemplo:
-
La sentencia de consulta es la siguiente:
* and h : nu2h05202.nu8 and m: NET | select ts_regression_predict(stamp, value, 200, 'origin') from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log group by stamp order by stamp) Resultado de salida
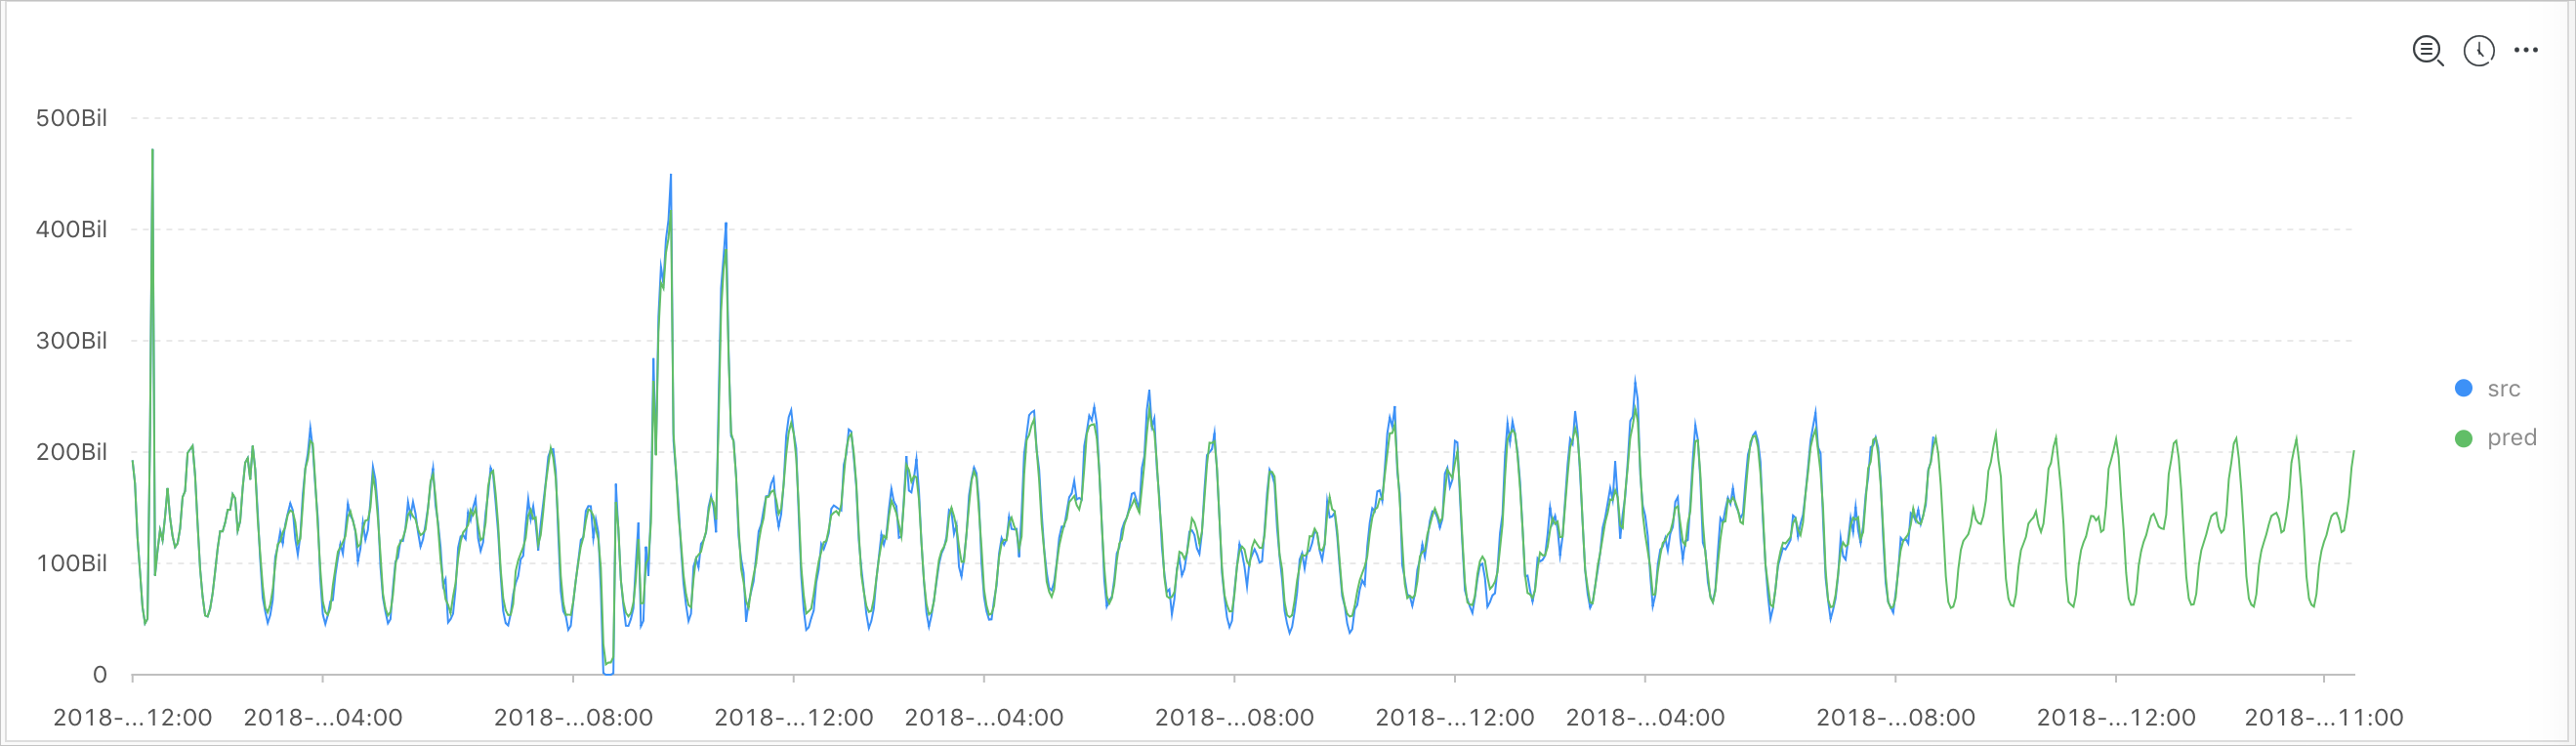
A continuación se describen los elementos de visualización.
Elemento de visualización | Descripción | |
Eje horizontal | unixtime | La marca de tiempo Unix de los datos. Unidad: segundos. |
Eje vertical | src | Los datos sin procesar. |
predict | Los datos generados después de realizar la operación de filtrado. | |
ts_anomaly_filter
Formato de la función:
select ts_anomaly_filter(lineName, ts, ds, preds, probs, nWatch, anomalyType)A continuación se describen los parámetros del formato de la función.
Parámetro | Descripción | Valor |
lineName | El nombre de cada curva. El valor es de tipo varchar. | N/A |
ts | La secuencia temporal de la curva, que indica el tiempo en la curva actual. El valor del parámetro es un arreglo de puntos en el tiempo de tipo de datos double, ordenados de forma ascendente. | N/A |
ds | La secuencia de valores reales de la curva. El valor del parámetro es un arreglo de puntos de datos de tipo de datos double. Este valor tiene la misma longitud que el valor del parámetro ts. | N/A |
preds | La secuencia de valores predichos de la curva. El valor del parámetro es un arreglo de puntos de datos de tipo de datos double. Este valor tiene la misma longitud que el valor del parámetro ts. | N/A |
probs | La secuencia de resultados de detección de anomalías de la curva. El valor del parámetro es un arreglo de puntos de datos de tipo de datos double. Este valor tiene la misma longitud que el valor del parámetro ts. | N/A |
nWatch | El número de valores reales observados recientemente en la curva. El valor es de tipo de datos long. Debe ser menor que el número de puntos en el tiempo de la curva. | N/A |
anomalyType | El tipo de anomalía que se va a filtrar. El valor es de tipo de datos long. | Valores válidos:
|
Ejemplo:
-
La sentencia de consulta es la siguiente:
* | select res.name, res.ts, res.ds, res.preds, res.probs from ( select ts_anomaly_filter(name, ts, ds, preds, probs, cast(5 as bigint), cast(1 as bigint)) as res from ( select name, res[1] as ts, res[2] as ds, res[3] as preds, res[4] as uppers, res[5] as lowers, res[6] as probs from ( select name, array_transpose(ts_predicate_ar(stamp, value, 10)) as res from ( select name, stamp, value from log where name like '%asg-%') group by name)) ); -
Resultado de salida
| name                     | ts                                                   | ds          | preds     | probs       |
| ------------------------ | ---------------------------------------------------- | ----------- | --------- | ----------- |
| asg-bp1hylzdi2wx7civ0ivk | [1.5513696E9, 1.5513732E9, 1.5513768E9, 1.5513804E9] | [1,2,3,NaN] | [1,2,3,4] | [0,0,1,NaN] |