Compatibilidad
Esta función se puede utilizar en expresiones de filtro, ordenamiento y fórmula.
Los campos del documento que se usan como parámetros de la función deben crearse como atributo.
tag_match: Coincidencia de etiquetas para puntuación
Descripción general
La función tag_match satisface diversos requisitos de coincidencia entre consultas y documentos. Resulta especialmente útil para personalizar los resultados de búsqueda. Por ejemplo, permite priorizar tiendas que un usuario ha marcado como favoritas o mostrar noticias de deportes y entretenimiento según sus preferencias. La funcionalidad básica de tag_match consiste en almacenar una serie de pares clave-valor en un campo de matriz de un documento. Posteriormente, puede pasar la información correspondiente de clave-valor en la consulta mediante kvpairs clause. La función tag_match busca en el documento las claves especificadas en la consulta, calcula una puntuación para cada clave coincidente y combina estas puntuaciones en una puntuación final. Este resultado se puede usar para asignar puntuaciones y ponderaciones, o bien para filtrar.
El proceso de cálculo es el siguiente: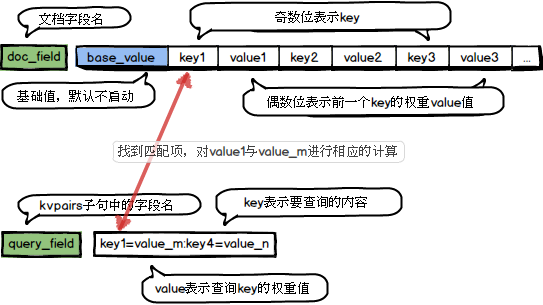
Uso
Sintaxis básica:
tag_match(query_key, doc_field, kv_op, merge_op)
Sintaxis avanzada:
tag_match(query_key, doc_field, kv_op, merge_op, has_default, doc_kv, max_kv_count)
-
Parámetros
query_key: Especifica los pares clave-valor de la consulta que se utilizan para la coincidencia. Estos pares se pasan a través de la cláusula kvpairs. Las claves y los valores se separan con un signo igual (=), y los múltiples pares clave-valor se separan con dos puntos (:). Por ejemplo,
kvpairs=query_tags:10=0.67:960=0.85:1=48indica que el parámetroquery_tagscontiene tres elementos (10, 960 y 1) con sus valores correspondientes (0.67, 0.85 y 48). La consulta también puede contener únicamente una lista de claves, comokvpairs=cats:10:960:1.doc_field: Especifica el campo del documento que almacena los pares clave-valor. Este campo debe ser una matriz de enteros (
int_array) o una matriz de punto flotante (float_array,double_array). Si utiliza una matriz de punto flotante, los valores de las claves se convierten aint64para realizar la coincidencia. La matriz almacena claves y valores en una secuencia alternada:[key0, value0, key1, value1, ...]. Las claves se encuentran en índices pares (0, 2, etc.) y sus valores correspondientes en los índices impares subsiguientes.kv_op: Operación que se realiza sobre los valores de las claves de la consulta y del documento cuando coinciden. Los operadores compatibles incluyen:
max(máximo),min(mínimo),sum(suma),avg(promedio),mul(producto),query_value(usa el valor de la clave de la consulta),doc_value(usa el valor del documento) ynumber(una constante especificada).merge_op: Combina los resultados de múltiples coincidencias de claves. Los operadores compatibles incluyen:
max(máximo),min(mínimo),sum(suma),avg(promedio) yfirst_match(utiliza el resultado del primer cálculo dekv_ope ignora el resto).has_default: Valor booleano que especifica si se debe usar una puntuación inicial. El valor predeterminado es
false. Si se establece entrue, el primer valor endoc_fieldse trata como un valor predeterminado, similar a una puntuación base. La estructura pasa a ser[init_score, k0, v0, k1, v1, ...].doc_kv: Valor booleano que especifica la estructura de
doc_field. El valor predeterminado estrue, lo que significa que el campo contiene pares clave-valor. Si se establece enfalse, el campo contiene solo claves.max_kv_count: Número máximo de pares clave-valor que se pueden pasar en la consulta. El valor predeterminado es 50. Puede aumentar este límite, pero no puede exceder 512.
Valor de retorno
Devuelve un valor double que representa la puntuación final. Si has_default es false y no se encuentran coincidencias, devuelve 0. Para obtener un resultado int64, utilice la función int_tag_match. La función int_tag_match es funcionalmente idéntica a tag_match, pero no se puede usar en una expresión de clasificación.
Casos de uso
Escenario 1: En un foro en línea grande, las publicaciones pueden tener diversas etiquetas (comedia, deportes, noticias, música, ciencia, etc.). Al enviar documentos a OpenSearch, puede asignar un ID de etiqueta a cada una (por ejemplo, comedia: 1, deportes: 5, noticias: 3, música: 6) y almacenarlas en un campo tag. Si preprocesa las publicaciones, incluso puede determinar un peso para cada etiqueta. Por ejemplo, una publicación sobre noticias deportivas divertidas podría tener un peso de comedia de 0.5, un peso de deportes de 0.5 y un peso de noticias de 0.1. El campo tag para esta publicación sería [1, 0.5, 5, 0.5, 3, 0.1]. Para los usuarios registrados, puede identificar sus etiquetas de interés con el tiempo.
Por ejemplo, un usuario llamado nba_fans está interesado en deportes y comedia, con pesos correspondientes de 0.6 y 0.3. Cuando este usuario realiza una consulta, puede agregar esta información a la consulta mediante la cláusula kvpairs. Si la cláusula kvpairs se denomina user_tag, su valor para nba_fans sería 5=0.6:1=0.3. Al configurar tag_match(user_tag, tag, mul, sum) en la expresión de clasificación fina, puede impulsar las publicaciones que coinciden con los intereses del usuario y clasificarlas más alto.
Con el parámetro kv_op establecido en mul, la función multiplica los valores de la consulta y del documento. Las puntuaciones individuales se calculan de la siguiente manera: deportes (0.5 0.6 = 0.3) y comedia (0.5 0.3 = 0.15). Con el parámetro merge_op establecido en sum, la función suma las puntuaciones de deportes y comedia (0.3 + 0.15 = 0.45). Esta puntuación total se añade a la puntuación final de clasificación. De este modo, puede aplicar puntuaciones y ponderaciones a las publicaciones según los intereses del usuario.
Escenario 2:
Los productos pueden tener múltiples etiquetas de atributos, como 1 para "adulto joven" (edad), 2 para "mediana edad" (edad), 3 para "minimalista" (estilo), 4 para "a la moda" (estilo), 5 para "femenino" (género) y 6 para "masculino" (género).
Suponga que solo desea marcar las etiquetas de un producto sin asignar pesos. Puede almacenar estas etiquetas en un campo options. Por ejemplo, un artículo de ropa a la moda para mujeres jóvenes tendría un campo options con valor [1, 4, 5]. Tenga en cuenta que esta matriz contiene solo claves de etiquetas, no valores. Los usuarios también tienen sus propias etiquetas de atributos que corresponden a las etiquetas del producto. Por ejemplo, una usuaria joven que suele comprar ropa minimalista podría tener una consulta como user_options=1:3:5. Note que esta cláusula kvpairs también contiene solo claves de etiquetas.
Para impulsar los productos que coinciden con las preferencias de etiquetas del usuario, puede usar tag_match(user_options, options, 10, sum, false, false) en la fórmula. Aquí, user_options y options especifican la información de etiquetas de la consulta y del documento, respectivamente. El parámetro kv_op se establece en un valor constante de 10, lo que asigna una puntuación de 10 a cada etiqueta coincidente. El parámetro has_default es false porque no se necesita un valor inicial. El parámetro doc_kv es false, lo que indica que el campo del documento almacena solo claves.
Cuando la usuaria joven busca el artículo de ropa descrito anteriormente, las etiquetas "adulto joven" y "femenino" coincidirán. La puntuación para cada coincidencia es 10. Con sum como merge_op, la puntuación final de impulso para este producto es 20. Este método le permite aplicar puntuaciones y ponderaciones a los documentos coincidentes incluso sin información de peso de etiquetas.
Notas de uso
Los campos que se utilizan como parámetros de la función deben crearse como atributo.
Al usar
tag_matchen una cláusulafilterosort, encierre los parámetrosquery_key,kv_op,merge_op,has_defaultydoc_kventre comillas dobles. Por ejemplo:sort=-tag_match("user_options", options, "mul", "sum", "false", "true", 100).La función
tag_matchrealiza la coincidencia de claves mediante comparación de enteros. Por lo tanto, las claves tanto en la consulta como en el documento deben ser números enteros. Si una clave es un número de punto flotante,tag_matchla convierte a entero para la comparación.
Ejemplos
Suponga que los documentos pueden tener los siguientes 10 tipos de etiquetas:
1 - Finance
2 - Technology
3 - Sports
4 - Entertainment
5 - Fashion
6 - Education
7 - Travel
8 - Gaming
9 - Popular Science
10 - Healthcare
Ejemplo 1: Misma palabra clave, diferentes etiquetas
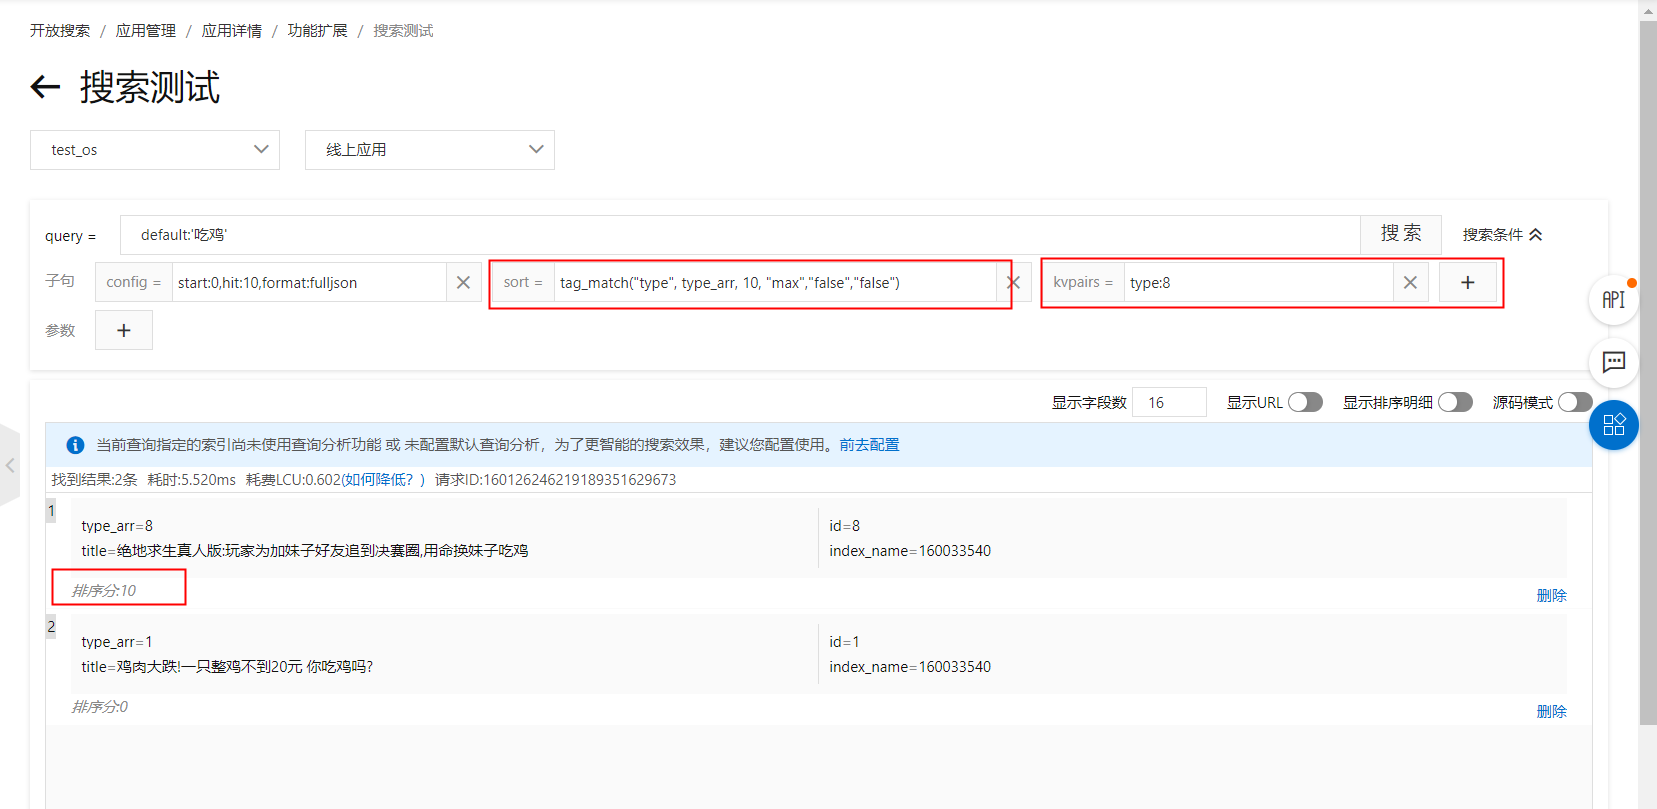
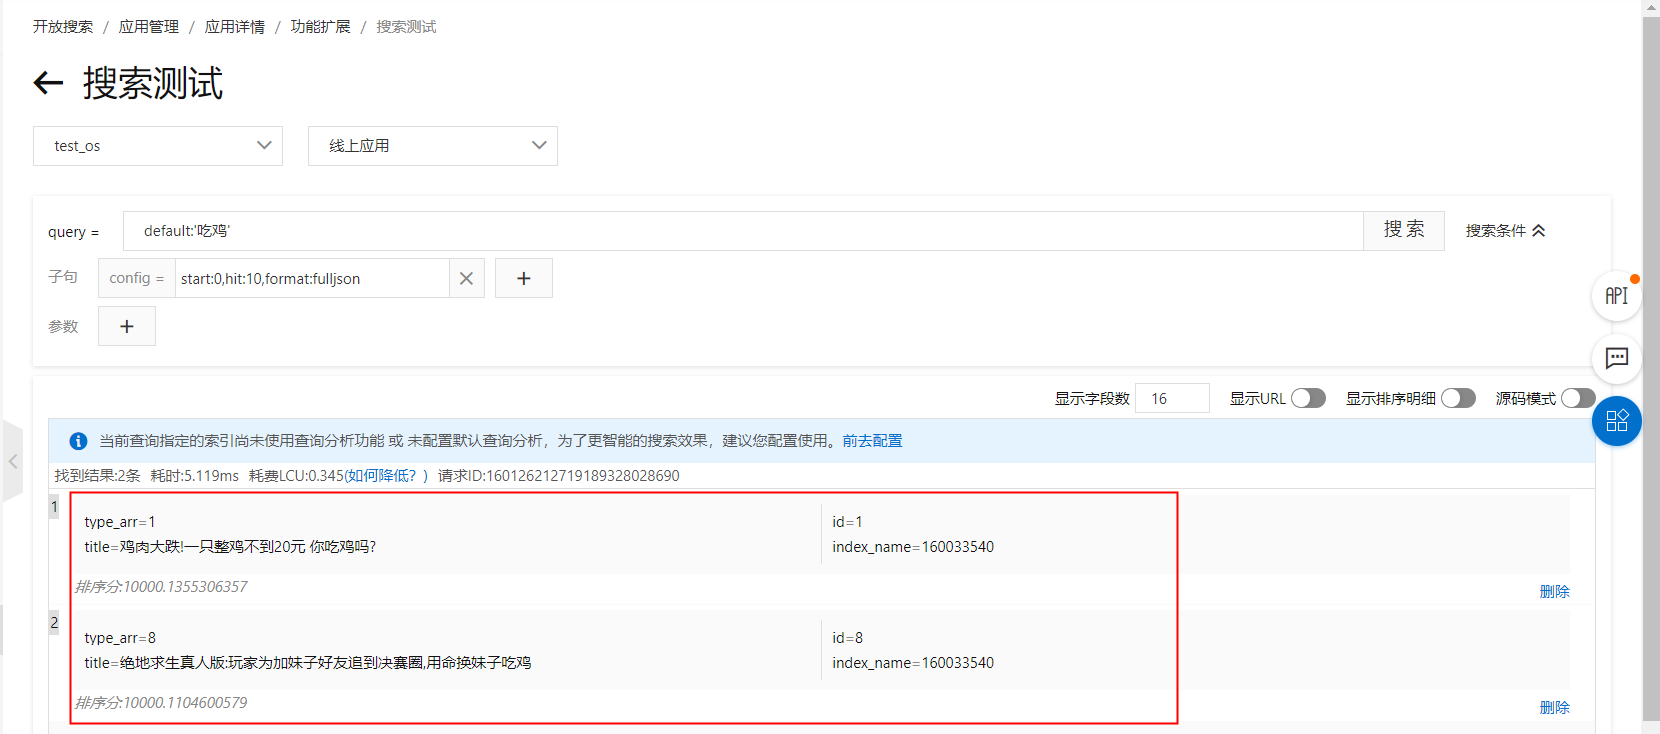 Como se muestra en la figura anterior, una búsqueda de "battle royale" devuelve dos documentos. Sin embargo, los documentos son de diferentes tipos: 1-Finance y 8-Gaming. Si desea mostrar primero el documento con la etiqueta "Gaming", puede configurar la función tag_match. Las siguientes secciones demuestran cómo configurar esta función en una expresión de clasificación y en una cláusula de ordenamiento:
kvpairs: type:8
Ranking expression: tag_match(type, type_arr, 10, max,false,false)
sort clause: tag_match("type", type_arr, 10, "max","false","false")
Resultado con expresión de clasificación: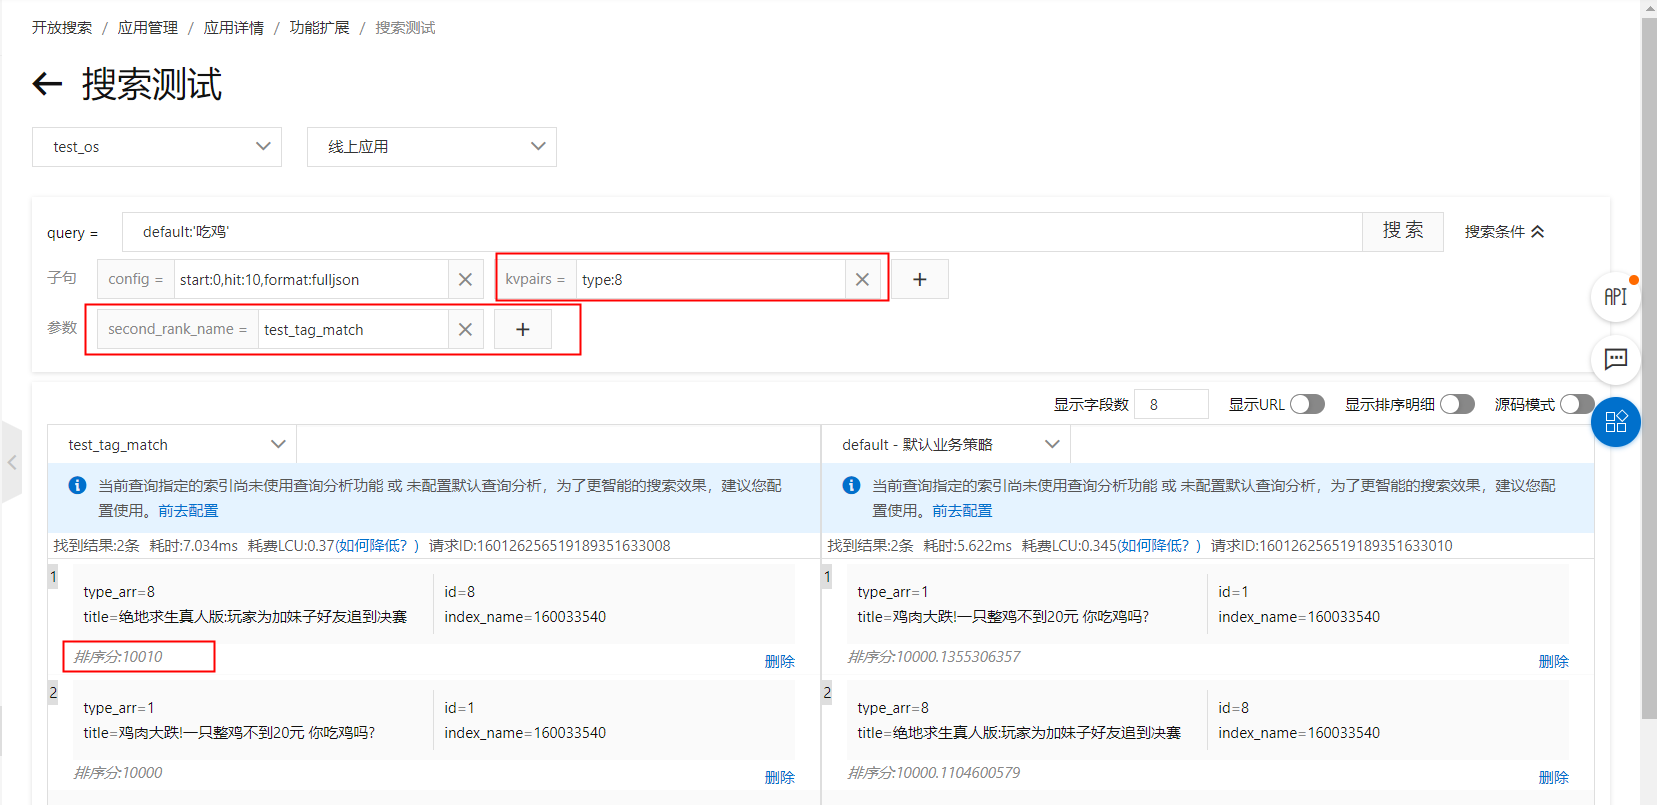 Resultado con cláusula de ordenamiento:
Ejemplo 2: Puntuación combinada para múltiples etiquetas (para personalización de usuario)
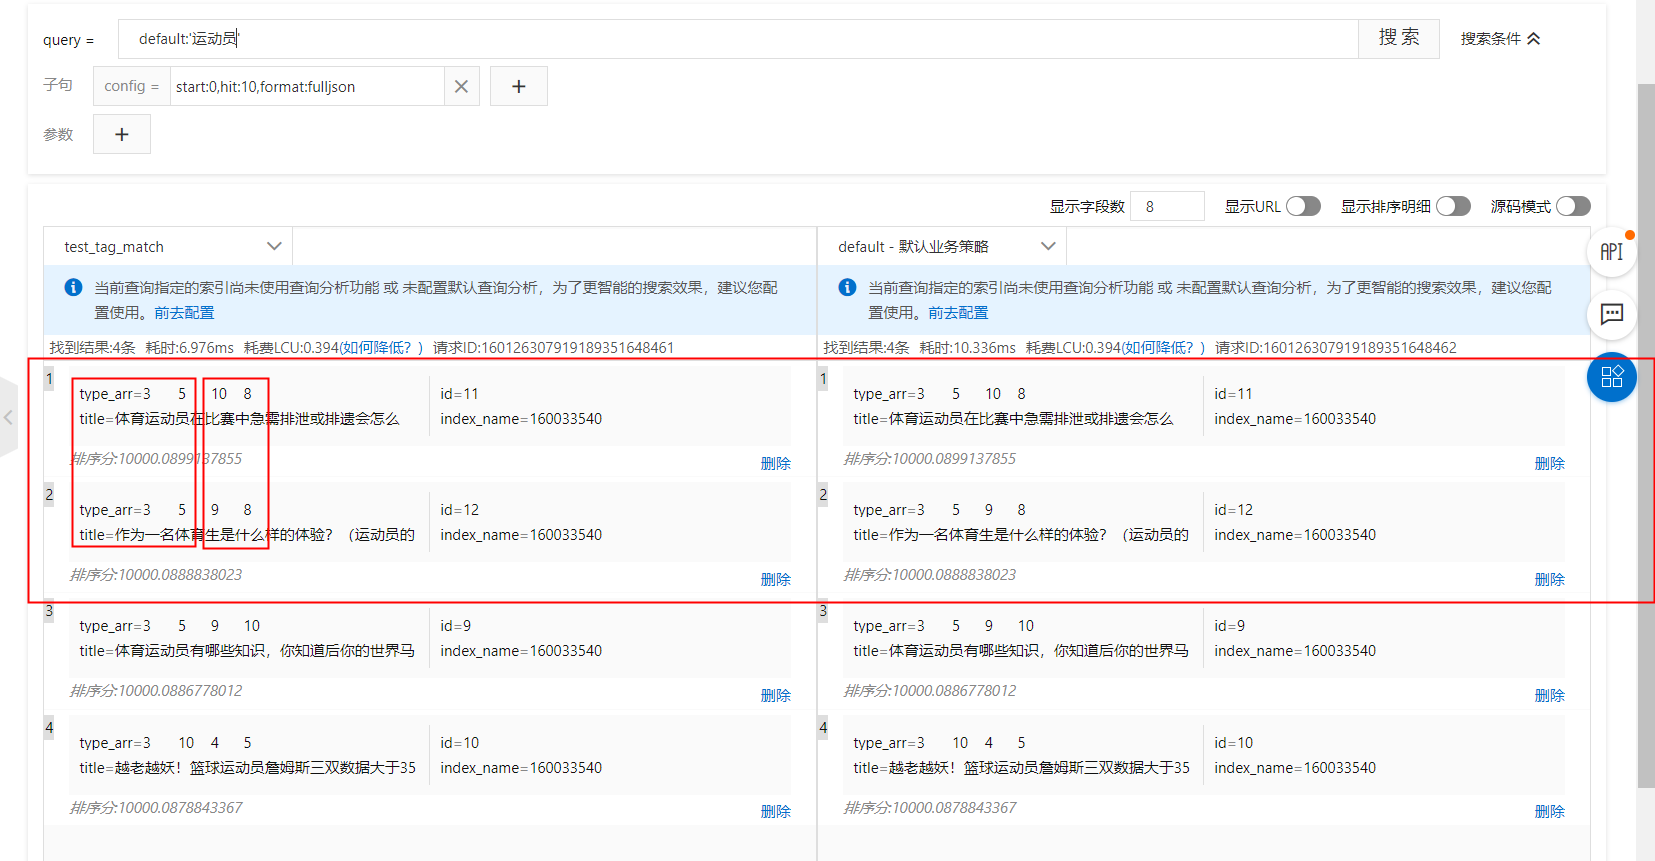 Como se muestra en la imagen, cuando las etiquetas principales son las mismas, es necesario hacer coincidir las puntuaciones de las etiquetas secundarias. Los siguientes ejemplos muestran cómo configurar esto en una expresión de clasificación y en una cláusula de ordenamiento:
kvpairs: type:3=2:10=1
Ranking expression: tag_match(type, type_arr, 10, sum,false,true)
sort clause: tag_match("type", type_arr, 10, "sum","false","true")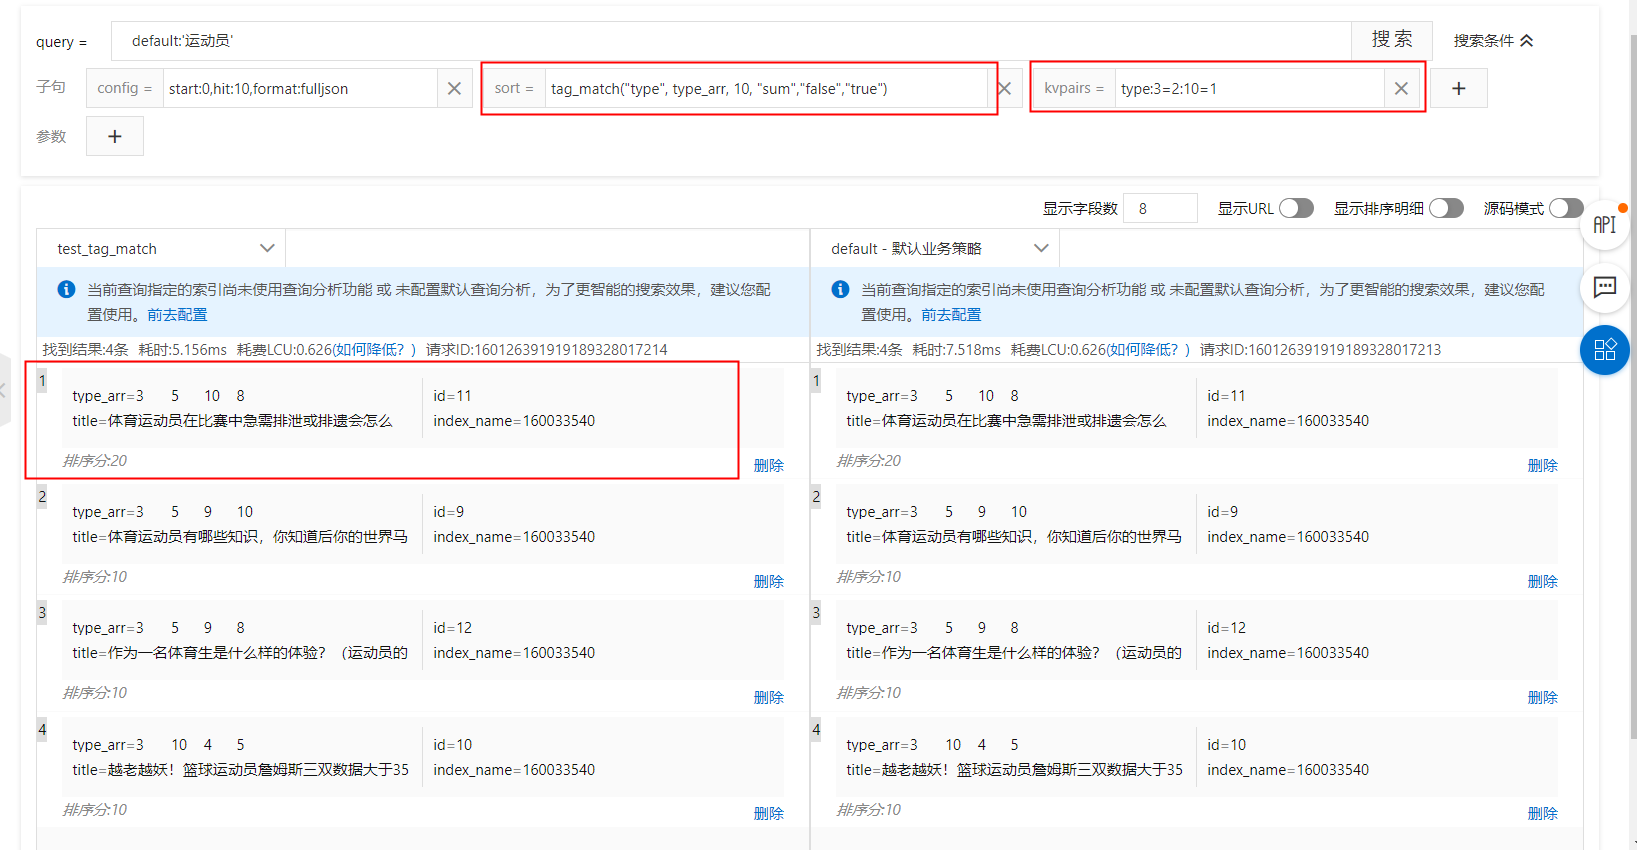
Ejemplo 3: Múltiples etiquetas del mismo tipo con diferentes puntuaciones
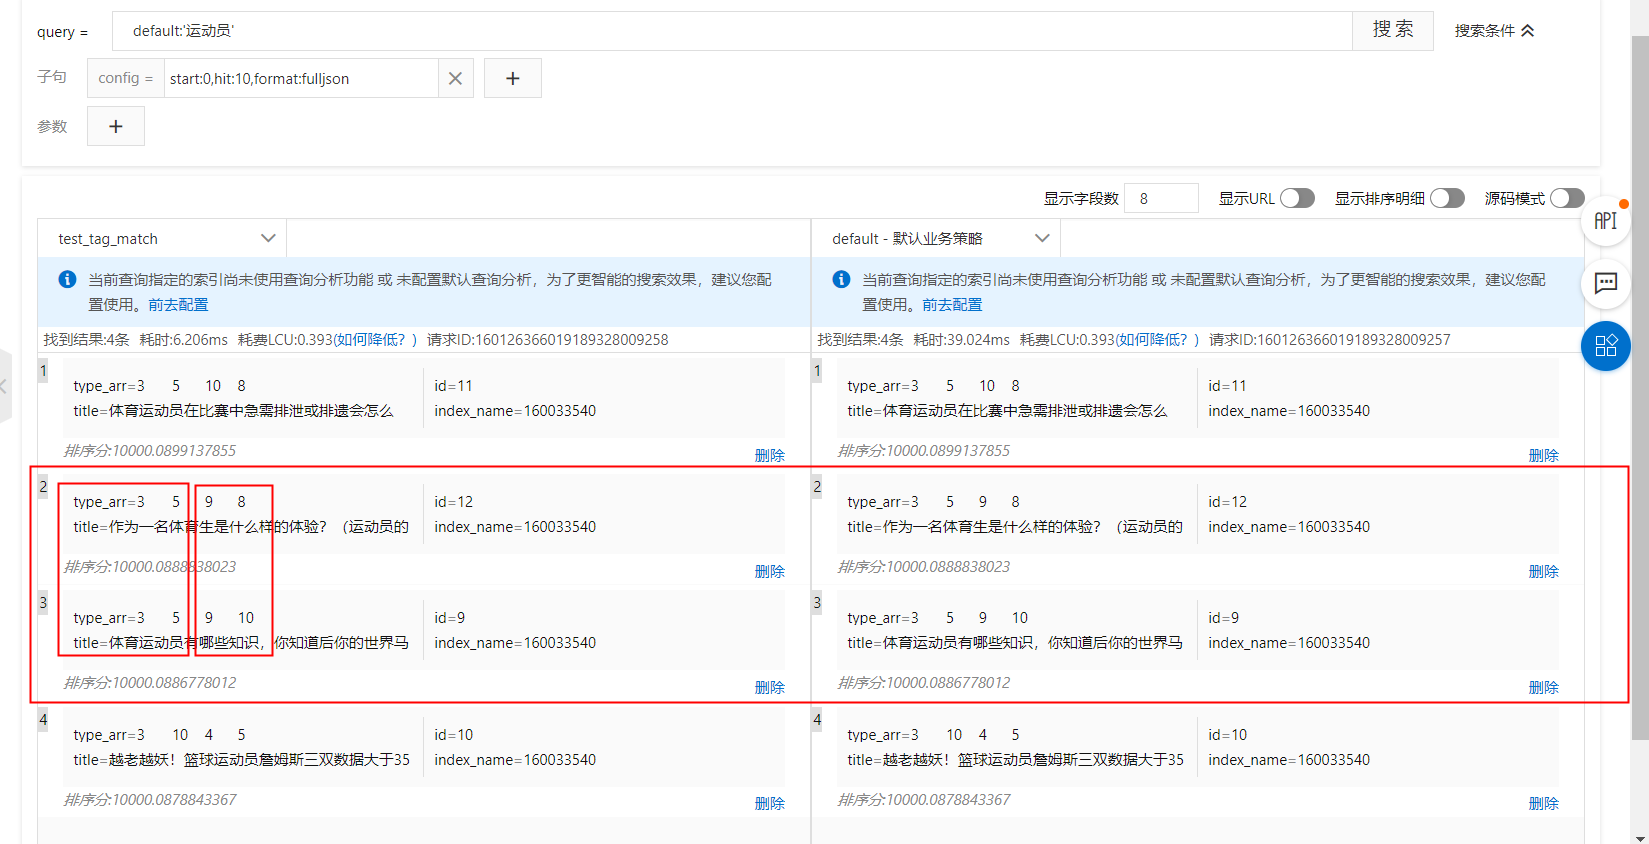 Como se muestra en la imagen, el contenido resaltado en rojo tiene las mismas etiquetas, pero cada etiqueta tiene una puntuación diferente. Los siguientes ejemplos muestran cómo configurar esto en una expresión de clasificación y en una cláusula de ordenamiento:
kvpairs: type:3=2:9=2
Ranking expression: tag_match(type, type_arr, sum, sum,false,true)
sort clause: tag_match("type", type_arr, "sum", "sum","false","true")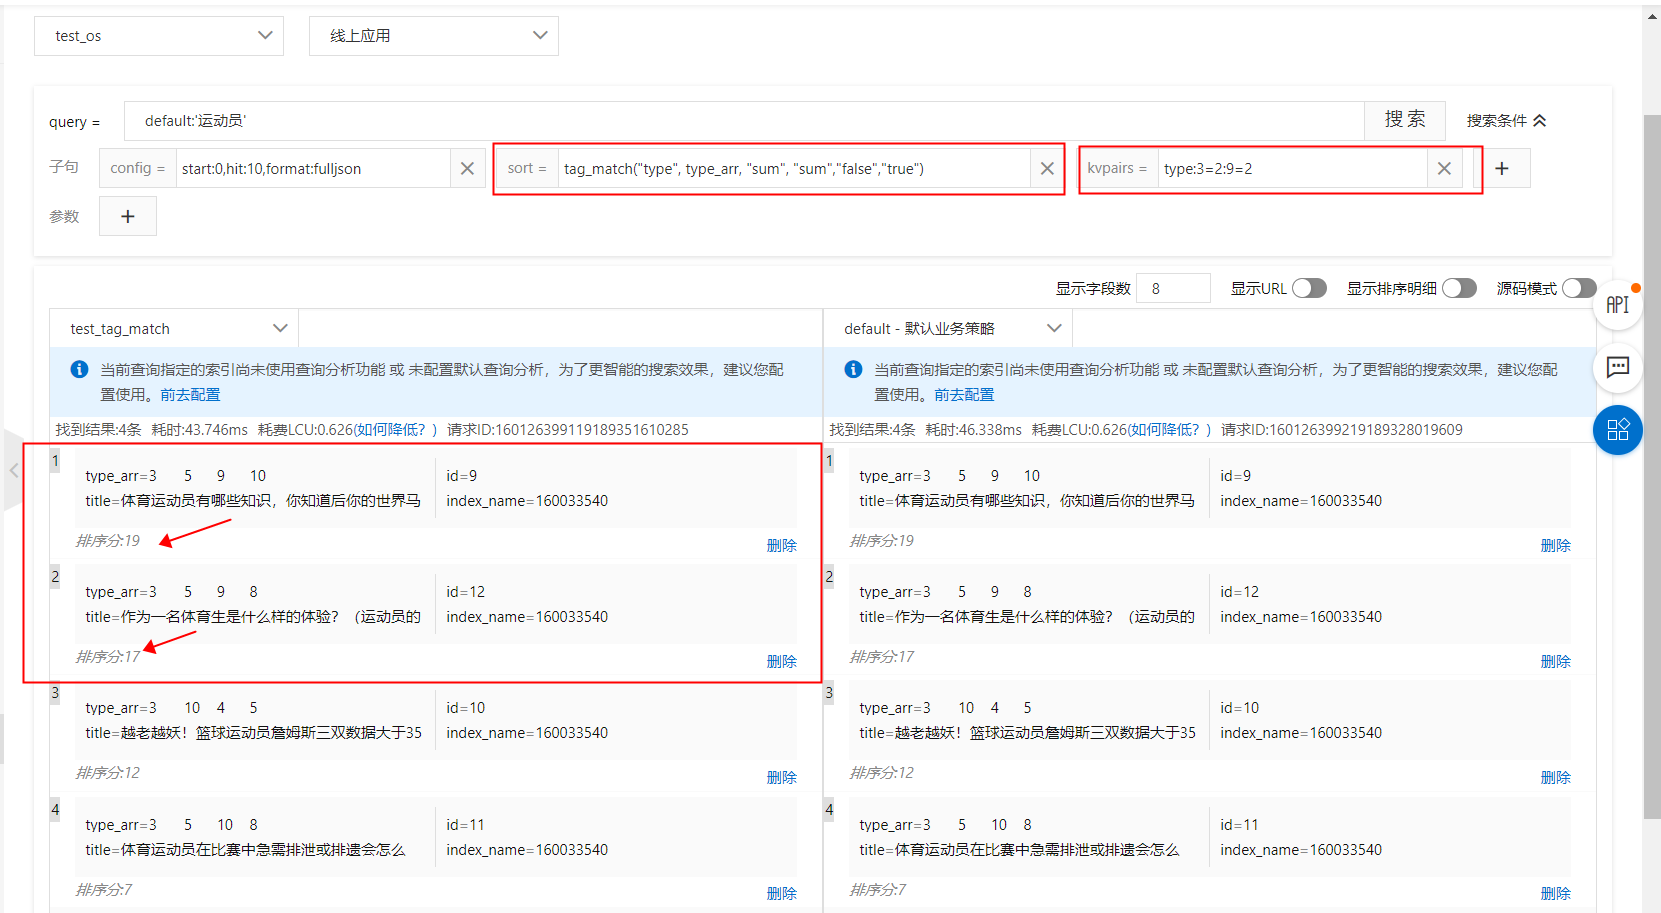
Ejemplo de SDK de Java: Java SDK Search Demo