La consola de administración de ApsaraDB for MongoDB ofrece una amplia variedad de métricas de rendimiento para monitorear el estado de sus instancias.
Contexto
Tenga en cuenta la siguiente información sobre la función de monitoreo en ApsaraDB for MongoDB:
La función de monitoreo difiere entre las versiones nueva y anterior de la consola de administración de ApsaraDB for MongoDB. Se recomienda usar la nueva consola para acceder a más funciones.
-
Si usa la nueva consola de administración, se espera una frecuencia de recopilación de una vez por segundo o cada 300 segundos para una instancia en los siguientes casos:
Algunas instancias existentes conservan su configuración original de frecuencia de recopilación.
-
La instancia usa una frecuencia de recopilación configurada en la versión anterior de la consola de administración de ApsaraDB for MongoDB.
Si usa la consola de administración anterior y la frecuencia de recopilación de una instancia es de una vez cada 60 segundos, este comportamiento es esperado. Indica que la instancia se creó después de estandarizar la frecuencia de recopilación a una vez cada 60 segundos. Para obtener más información, consulte announcement about the change of the collection frequency to 60 seconds.
Notas
Si recibe un mensaje de alerta de Alibaba Cloud, por ejemplo, una alerta que indica que el uso de CPU supera el 80%, analice los datos de monitoreo en la consola para solucionar el problema. Filtre por nodo para comprobar e identificar posibles anomalías.
Los datos de monitoreo se conservan durante un máximo de 7 días.
Procedimiento
Inicie sesión en la consola de ApsaraDB for MongoDB.
En la esquina superior izquierda de la página, seleccione el resource group y la región a los que pertenece la instancia.
En el panel de navegación izquierdo, haga clic en Replica Set Instances o Sharded Cluster Instance según el tipo de instancia.
En la página mostrada, busque la instancia que desea gestionar y haga clic en su ID.
En el panel de navegación izquierdo, haga clic en Monitoring Data.
-
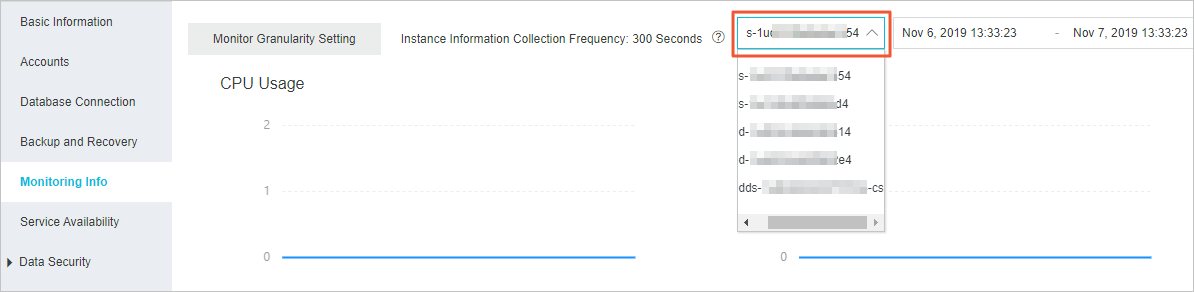
Según el tipo de instancia, seleccione el nodo para consultar sus datos de monitoreo.
NotaDe forma predeterminada, la consola muestra los datos de monitoreo de las últimas 24 horas. También puede seleccionar un rango de tiempo para consultar datos históricos.
Instancia de nodo único: se muestran los datos de monitoreo del nodo primario. No es posible modificar esta selección.
Instancia de conjunto de réplicas: en la parte superior de la página, seleccione un nodo primario o secundario.
-
Instancia de clúster fragmentado: en la parte superior de la página, seleccione un nodo mongos, un nodo shard o un nodo ConfigServer.
NotaLos ID de nodo con prefijo
s-
corresponden a nodos mongos, aquellos con prefijo
d-
son nodos shard y los que tienen sufijo
-cs
son nodos ConfigServer.
Métricas
| Métrica | Descripción |
| Uso de CPU | cpu_usage: porcentaje de uso de CPU de la instancia. |
| Uso de memoria | mem_usage: porcentaje de uso de memoria de la instancia. |
| IOPS | Número de operaciones de E/S por segundo (IOPS). Esta métrica incluye:
|
| Uso de IOPS | iops_usage: proporción de IOPS usadas por la instancia respecto al máximo de IOPS disponibles. |
| Uso de espacio en disco | Espacio en disco usado por la instancia. Esta métrica incluye:
|
| Uso de disco | disk_usage: proporción del espacio total en disco usado por la instancia respecto al máximo disponible. |
| QPS de operaciones | Número de operaciones por segundo (QPS) en la instancia. Esta métrica incluye:
|
| Conexiones | current_conn: número actual de conexiones a la instancia. |
| Cursores | Número de cursores usados actualmente por la instancia. Esta métrica incluye:
|
| Tráfico de red | Tráfico de red de la instancia. Esta métrica incluye:
|
| Longitud de cola de bloqueo global | Longitud de las colas en espera de bloqueos globales en la instancia. Esta métrica incluye:
|
| WiredTiger | Métricas de caché del motor WiredTiger. Esta métrica incluye:
|
| Latencia de replicación | repl_lag: latencia de sincronización de datos entre los nodos primario y secundario. |
| Colas de solicitudes WT | Número de solicitudes concurrentes de lectura y escritura en proceso (out) y número de espacios disponibles para solicitudes concurrentes (available). Esta métrica incluye:
|
| Latencia de E/S | iocheck_cost: mide el tiempo de respuesta de las operaciones de E/S.Nota Esta métrica aplica únicamente a instancias de conjunto de réplicas. |