La Python Software Foundation dejará de dar mantenimiento a Python 2 pronto. MaxCompute ya es compatible con Python 3, específicamente con CPython-3.7.3. En este tema se describe cómo escribir una función de agregación definida por el usuario (UDAF) en Python 3.
Estructura del código de una UDAF
Con Get started with MaxCompute Studio puede escribir el código de una función de agregación definida por el usuario (UDAF) en Python 3. El código debe contener la siguiente información:
-
Importar módulos: obligatorio.
Como mínimo, debe importar
from odps.udf import annotateyfrom odps.udf import BaseUDAF. La instrucciónfrom odps.udf import annotateimporta el módulo de firma de función, lo que permite que MaxCompute reconozca la firma definida en el código. Por su parte,from odps.udf import BaseUDAFimporta la clase base para las UDAF de Python. En la clase derivada debe implementar métodos comoiterate,mergeyterminate.Si el código de la UDAF necesita hacer referencia a recursos de archivo o de tabla, incluya
from odps.distcache import get_cache_filepara los recursos de archivo ofrom odps.distcache import get_cache_tablepara los recursos de tabla. -
Firma de función: obligatorio.
El formato es
@annotate(<signature>). El elementosignaturedefine los tipos de datos de los parámetros de entrada y del valor de retorno de la función. Para obtener más información sobre las firmas de función, consulte Function signature and data types. -
Clase de Python personalizada (clase derivada): obligatorio.
Esta clase es la unidad organizativa del código de la UDAF. Define las variables y los métodos que implementan su lógica de negocio. También puede hacer referencia a bibliotecas de terceros integradas, archivos o recursos de tabla en el código. Para obtener más información, consulte Third-party libraries o Reference resources.
-
Implementar los métodos de la clase de Python: obligatorio.
La implementación de la clase de Python incluye los siguientes métodos. Puede implementarlos según sus necesidades.
Definición del método
Descripción
BaseUDAF.new_buffer()Devuelve un búfer para el valor intermedio de la función de agregación. El elemento
bufferdebe ser un objeto Marshal, como LIST o DICT. El tamaño del elementobufferno debe aumentar conforme crece el volumen de datos. En casos extremos, el tamaño del elementobufferdespués de serializar el objeto no debe superar los 2 MB.BaseUDAF.iterate(buffer[, args, ...])Agrega los elementos
argsen el valor intermediobuffer.BaseUDAF.merge(buffer, pbuffer)Combina los valores intermedios
bufferypbuffer, y almacena el resultado enbuffer.BaseUDAF.terminate(buffer)Convierte el elemento
buffera un tipo de datos primitivo de MaxCompute SQL.
A continuación se muestra un ejemplo de código de una UDAF.
# Import the function signature module and the base class.
from odps.udf import annotate
from odps.udf import BaseUDAF
# Function signature.
@annotate('double->double')
# Custom Python class.
class Average(BaseUDAF):
# Implement the methods of the Python class.
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
        return buffer[0] / buffer[1]
La siguiente imagen muestra la lógica de implementación y el flujo de cálculo de una UDAF de MaxCompute diseñada para calcular el valor promedio (
avg
).
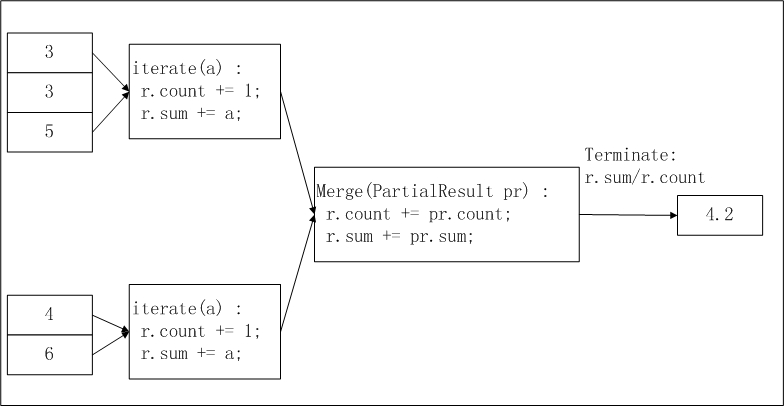
El elemento
pbuffer
corresponde a
pr
en la imagen, mientras que
buffer
corresponde a
r
.
La diferencia entre las UDAF de Python 2 y las de Python 3 radica en la versión subyacente de Python. Debe escribir su UDAF con base en las capacidades de la versión correspondiente.
Notas de uso
Python 3 no es compatible con Python 2, por lo que no se pueden usar ambos en la misma instrucción SQL. Considere esta compatibilidad antes de cambiar de versión.
Python 2 llegó al final de su vida útil (EOL) a principios de 2020. Se recomienda migrar los proyectos según su tipo.
Migración de UDAF de Python 2
La Python Software Foundation dejará de dar mantenimiento a Python 2 pronto. Se recomienda migrar los proyectos según su tipo:
Proyectos nuevos: aplica a proyectos de MaxCompute recién creados o a aquellos donde se escribe una UDAF de Python por primera vez. Se recomienda escribir todas las UDAF de Python en Python 3.
-
Proyectos existentes: aplica a proyectos de MaxCompute que ya cuentan con varias UDAF de Python 2. Habilite Python 3 con precaución. Si planea migrar gradualmente todas las UDAF de Python 2 a Python 3, utilice los siguientes métodos:
Trabajos y UDAF nuevas: escríbalos en Python 3 y habilite Python 3 a nivel de sesión. Para obtener más información sobre cómo habilitar Python 3, consulte Enable Python 3.
-
UDAF de Python 2: reescriba las UDAF de Python 2 para que sean compatibles tanto con Python 2 como con Python 3. Para obtener más información sobre cómo reescribir el código, consulte Porting Python 2 Code to Python 3.
NotaSi desea escribir una UDAF pública y otorgar permisos para que varios proyectos de MaxCompute la utilicen, se recomienda hacerla compatible tanto con Python 2 como con Python 3.
Habilitar Python 3
De forma predeterminada, MaxCompute utiliza Python 2. Para usar Python 3, incluya el siguiente indicador de sesión en su instrucción SQL.
set odps.sql.python.version=cp37;Bibliotecas de terceros
El entorno de ejecución integrado de Python 3 en MaxCompute no tiene instalada la biblioteca de terceros NumPy. Para usar una UDAF que requiera NumPy, debe cargar manualmente el paquete WHEEL de NumPy. Cuando descargue el paquete de NumPy desde PyPI o desde un espejo, el nombre del archivo será numpy-<version_number>-cp37-cp37m-manylinux1_x86_64.whl. Para obtener más información sobre cómo cargar un paquete, consulte Resource operations o UDF example: Use a third-party package in a Python UDF.
Firma de función y tipos de datos
La firma de función tiene el siguiente formato.
@annotate(<signature>)El elemento
signature
es una cadena que identifica los tipos de datos de los parámetros de entrada y del valor de retorno. Al ejecutar una UDAF, los tipos de datos de sus parámetros de entrada y de su valor de retorno deben coincidir con los especificados en la firma de función. Durante la fase de análisis sintáctico de la consulta, el sistema valida la llamada a la función con base en dicha firma. Si detecta una discrepancia de tipos, reporta un error. El formato específico es el siguiente.
'arg_type_list -> type'donde:
-
arg_type_list: representa los tipos de datos de los parámetros de entrada. Se pueden especificar varios parámetros de entrada separados por comas (,). Los tipos de datos compatibles son BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, tipos de datos complejos (ARRAY, MAP, STRUCT) y tipos de datos complejos anidados.El elemento
arg_type_listtambién admite un asterisco (*) o una cadena vacía ('').Si
arg_type_listes un asterisco (*), indica que la función acepta cualquier cantidad de parámetros de entrada.Si
arg_type_listes una cadena vacía (''), indica que la función no tiene parámetros de entrada.
Para obtener más información sobre la sintaxis extendida de la anotación Resolve, consulte Dynamic parameters for UDAFs and UDTFs.
type: representa el tipo de datos del valor de retorno. Una UDAF devuelve solo una columna. Los tipos de datos compatibles incluyen BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), tipos de datos complejos (ARRAY, MAP, STRUCT) y tipos de datos complejos anidados.
Al escribir el código de la UDAF, seleccione los tipos de datos adecuados según la edición de tipos de datos de su proyecto de MaxCompute. Para obtener más información sobre las ediciones de tipos de datos y los tipos compatibles con cada una, consulte
.
A continuación se muestran algunas firmas de función válidas.
|
Ejemplo de firma de función |
Descripción |
|
|
Los tipos de los parámetros de entrada son BIGINT y DOUBLE, y el tipo del valor de retorno es STRING. |
|
|
La función acepta cualquier cantidad de parámetros de entrada y el tipo del valor de retorno es STRING. |
|
|
La función no tiene parámetros de entrada y el tipo del valor de retorno es DOUBLE. |
|
|
El tipo del parámetro de entrada es ARRAY |
Para garantizar que los tipos de datos de su UDAF de Python coincidan con los tipos compatibles con MaxCompute, debe utilizar las asignaciones de tipos de datos correctas. En la siguiente tabla se describen estas asignaciones.
|
Tipo de MaxCompute SQL |
Tipo de Python 3 |
|
BIGINT |
INT |
|
STRING |
UNICODE |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
DATETIME.DATETIME |
|
FLOAT |
FLOAT |
|
CHAR |
UNICODE |
|
VARCHAR |
UNICODE |
|
BINARY |
BYTES |
|
DATE |
DATETIME.DATE |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
Referencia a recursos
Las UDAF de Python pueden hacer referencia a recursos de archivo y de tabla mediante el módulo odps.distcache.
-
odps.distcache.get_cache_file(resource_name): devuelve un objeto similar a un archivo para el recurso de archivo especificado.-
El parámetro
resource_namees de tipo STRING y corresponde al nombre de un recurso de archivo existente en el proyecto actual de MaxCompute. Si el nombre del recurso de archivo no es válido o el recurso no existe, se genera una excepción.NotaPara acceder a un recurso desde una UDAF, debe declarar el recurso referenciado cuando cree la UDAF. De lo contrario, se reportará un error.
El valor de retorno es un objeto similar a un archivo. Cuando termine de usarlo, llame al método
closepara liberar el archivo de recurso abierto.
-
-
odps.distcache.get_cache_table(resource_name): devuelve un objeto generador para el recurso de tabla especificado.El parámetro
resource_namees de tipo STRING y corresponde al nombre de un recurso de tabla existente en el proyecto actual de MaxCompute. Si el nombre del recurso de tabla no es válido o el recurso no existe, se genera una excepción.El valor de retorno es de tipo GENERATOR. Quien realiza la llamada recorre el generador para recuperar el contenido de la tabla. Cada iteración devuelve un registro de la tabla en forma de arreglo.
Para obtener más información sobre su uso, consulte Reference resources (Python 3 UDF) y Reference resources (Python 3 UDTF).
Notas de uso
Una vez que desarrolle una UDAF de Python 3 siguiendo el development flow, podrá llamarla en una instrucción de MaxCompute SQL. A continuación se describen los métodos de llamada:
Usar una UDF dentro de un proyecto de MaxCompute: este método es similar al de usar built-in functions. Puede utilizar una función definida por el usuario de la misma manera que una función integrada.
Usar una UDF entre proyectos: consiste en utilizar una UDF del Proyecto B dentro del Proyecto A. En la siguiente instrucción se muestra un ejemplo:
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Para obtener más información sobre cómo compartir recursos entre proyectos, consulte Cross-project resource access based on packages.
Para conocer el procedimiento completo de desarrollo y llamada de una UDAF de Python 3 con MaxCompute Studio, consulte Develop a Python UDF.
Parámetros dinámicos para UDAF
Firma de función
Para obtener más información sobre el formato de la firma de función de una UDAF de Python, consulte Function signature and data types.
-
Puede usar un asterisco (
*) en la lista de parámetros para aceptar cualquier cantidad de parámetros de entrada de cualquier tipo. Por ejemplo,@annotate('double,*->string')indica que el primer parámetro es de tipo DOUBLE, seguido de una lista con cualquier cantidad de parámetros de cualquier tipo. En este caso, debe escribir código para determinar la cantidad y los tipos de los parámetros de entrada, y luego aplicarles las operaciones correspondientes. Este comportamiento es similar al de la funciónprintfdel lenguaje C.NotaUn asterisco (
*) tiene un significado distinto cuando se usa en la lista de valores de retorno. -
Puede usar un asterisco (
*) en el valor de retorno de una UDTF para indicar cualquier cantidad de valores de retorno de tipo STRING. La cantidad de valores de retorno depende del número de alias configurados al llamar a la función. Por ejemplo, para@annotate("bigint,string->double,*"), el método de llamada esUDTF(x, y) as (a, b, c). En este ejemplo se establecen tres alias después deas:a,byc. El editor considera queaes de tipo DOUBLE porque el tipo de la primera columna del valor de retorno se especificó en la anotación, y quebycson de tipo STRING. Como se especificaron tres valores de retorno, cuando la UDTF llame aforward, el elementoforwarddeberá ser un arreglo de longitud 3. De lo contrario, se producirá un error en tiempo de ejecución.NotaEste tipo de error no se puede detectar en tiempo de compilación. Por lo tanto, quien llame a la UDTF debe respetar las reglas definidas por ella al establecer la cantidad de alias en la instrucción SQL. Dado que el número de valores de retorno de una función de agregación siempre es 1, esta función no aplica para una UDAF.
Ejemplo de UDAF
from odps.udf import annotate
from odps.udf import BaseUDAF
@annotate('bigint,*->string')
class MultiColSum(BaseUDAF):
    def new_buffer(self):
        return [0]
    def iterate(self, buffer, *args):
        for arg in args:
            buffer[0] += int(arg)
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
    def terminate(self, buffer):
        return str(buffer[0])
Una UDAF solo puede tener un valor de retorno. En el ejemplo anterior, el valor de retorno es la suma de varios parámetros de entrada, la cual se agrega y se suma entre varias filas. A continuación se muestra un ejemplo de uso.
-- Sums multiple input parameters.
SELECT my_multi_col_sum(a,b,c,d,e) from values (1,"2","3","4","5"), (6,"7","8","9","10") t(a,b,c,d,e);
-- The return value is 55.