Este tema describe cómo usar Spark para leer datos de varios tipos de orígenes y escribirlos en Hologres.
Contexto
Spark es un motor de análisis que procesa grandes volúmenes de datos de manera centralizada. Hologres se integra con Apache Spark y con E-MapReduce (EMR) Spark para ayudarle a construir almacenes de datos de forma eficiente. Hologres proporciona el Spark connector, que le permite escribir datos en Hologres por lotes. Con Spark puede leer datos de varios tipos de orígenes, como archivos, tablas de Hive, tablas de MySQL y tablas de PostgreSQL.
Hologres es compatible con PostgreSQL. Por lo tanto, puede usar Spark para leer datos de Hologres mediante PostgreSQL. Después, extraiga, transforme y cargue (ETL) los datos, y escríbalos de nuevo en Hologres o en otros destinos.
Requisitos previos
La versión de su instancia de Hologres es V0.9 o posterior. Consulte la versión de su instancia de Hologres en la página de detalles de la instancia dentro de la consola de Hologres. Si la versión de su instancia de Hologres es anterior a V0.9, actualice manualmente su instancia de Hologres en la consola de Hologres o únase al grupo de DingTalk de Hologres para obtener soporte técnico. Para obtener más información sobre cómo actualizar manualmente su instancia de Hologres en la consola de Hologres, consulte Instance upgrades. Para obtener más información sobre cómo obtener soporte técnico, consulte Get online support for Hologres.
Tiene instalado un entorno de Spark con una versión compatible con Hologres. De este modo, podrá ejecutar el comando
spark-shellen dicho entorno.
Uso de conexiones
Cuando usa el Spark connector de Hologres para leer o escribir datos, se utilizan conexiones de Java Database Connectivity (JDBC). Los siguientes factores determinan la cantidad de conexiones necesarias:
Cantidad de tareas paralelas de Spark: obtenga este valor en la interfaz de usuario de Spark mientras se ejecuta un trabajo.
Modo de escritura de datos: si usa el Spark connector para escribir datos en el modo fixed copy, cada tarea paralela utiliza una conexión JDBC. Si usa la instrucción INSERT para escribir datos, cada tarea paralela utiliza tantas conexiones JDBC como indique el valor de write_thread_size. Cada tarea paralela de lectura de datos utiliza una conexión JDBC.
Otros: cuando inicia un trabajo, es posible que se necesite obtener información del esquema. En ese caso, se utiliza una conexión JDBC durante un periodo breve.
Calcule la cantidad total de conexiones JDBC que utiliza un trabajo con las siguientes fórmulas:
Modo fixed copy:
Parallelism × 1 + 1Instrucción INSERT:
Parallelism × write_thread_size + 1
El paralelismo de las tareas de Spark depende de la configuración manual de parámetros y de la política de bloqueo de archivos de Hadoop.
Escritura de datos en Hologres con el Spark connector (recomendado)
Se recomienda usar el Spark connector integrado de Hologres para escribir datos en Hologres. El Spark connector se utiliza junto con Holo Client. En comparación con otros métodos de escritura, el Spark connector ofrece un mejor rendimiento. Siga estos pasos para escribir datos con el Spark connector. Para obtener más información sobre el código de ejemplo, consulte la sección Example of using the Spark connector to write data to Hologres de este tema.
Preparativos
-
Obtenga un paquete JAR.
El Spark connector está disponible para Spark 2 y Spark 3. Cuando use el Spark connector para escribir datos en Hologres, debe hacer referencia a un paquete JAR del Spark connector. Este paquete ya se publicó en el repositorio central de Maven. Utilice el siguiente archivo pom.xml como referencia para la configuración.
NotaLos conectores correspondientes también son de código abierto. Para obtener más información, visite la página alibabacloud-hologres-connectors.
<dependency>
    <groupId>com.alibaba.hologres</groupId>
    <artifactId>hologres-connector-spark-3.x</artifactId>
    <version>1.4.0</version>
    <classifier>jar-with-dependencies</classifier>
</dependency>
Descargue los paquetes JAR proporcionados por Hologres desde los siguientes enlaces:
-
Use el paquete JAR.
Ejecute el siguiente comando para iniciar Spark y cargar el conector:
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jarTambién puede ejecutar el siguiente comando para iniciar PySpark y cargar el conector:
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar
Ejemplo de uso del Spark connector para escribir datos en Hologres
A continuación se muestra un ejemplo de cómo usar el Spark connector para escribir datos en Hologres.
-
Cree una tabla en Hologres.
Ejecute la siguiente instrucción SQL en Hologres para crear la tabla donde desea escribir los datos:
CREATE TABLE tb008 ( id BIGINT primary key, counts INT, name TEXT, price NUMERIC(38, 18), out_of_stock BOOL, weight DOUBLE PRECISION, thick FLOAT, time TIMESTAMPTZ, dt DATE, by bytea, inta int4[], longa int8[], floata float4[], doublea float8[], boola boolean[], stringa text[] ); -
Prepare los datos en Spark y escríbalos en Hologres.
-
Ejecute el siguiente comando en la CLI para habilitar el Spark connector:
spark-shell --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Ejecute el comando
load spark-test.scalaen spark-shell para cargar los datos de ejemplo.El archivo spark-test.scala contiene los siguientes datos:
import java.sql.{Timestamp, Date}
import org.apache.spark.sql.types._
import org.apache.spark.sql.Row

val byteArray = Array(1.toByte, 2.toByte, 3.toByte, 'b'.toByte, 'a'.toByte)
val intArray = Array(1, 2, 3)
val longArray = Array(1L, 2L, 3L)
val floatArray = Array(1.2F, 2.44F, 3.77F)
val doubleArray = Array(1.222, 2.333, 3.444)
val booleanArray = Array(true, false, false)
val stringArray = Array("abcd", "bcde", "defg")

val data = Seq(
  Row(-7L, 100, "phone1", BigDecimal(1234.567891234), false, 199.35, 6.7F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("2021-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(6L, -10, "phone2", BigDecimal(1234.56), true, 188.45, 7.8F, Timestamp.valueOf("2021-01-01 00:00:00"), Date.valueOf("1970-01-01"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray),
  Row(1L, 10, "phone3\"", BigDecimal(1234.56), true, 111.45, null, Timestamp.valueOf("2020-02-29 00:12:33"), Date.valueOf("2020-07-23"), byteArray, intArray, longArray, floatArray, doubleArray, booleanArray, stringArray)
)

val schema = StructType(Array(
  StructField("id", LongType),
  StructField("counts", IntegerType),
  StructField("name", StringType, false), // The value false indicates that the value of this field cannot be null in the table.
  StructField("price", DecimalType(38, 12)),
  StructField("out_of_stock", BooleanType),
  StructField("weight", DoubleType),
  StructField("thick", FloatType),
  StructField("time", TimestampType),
  StructField("dt", DateType),
  StructField("by", BinaryType),
  StructField("inta", ArrayType(IntegerType)),
  StructField("longa", ArrayType(LongType)),
  StructField("floata", ArrayType(FloatType)),
  StructField("doublea", ArrayType(DoubleType)),
  StructField("boola", ArrayType(BooleanType)),
  StructField("stringa", ArrayType(StringType))
))

val df = spark.createDataFrame(
  spark.sparkContext.parallelize(data),
  schema
)
df.show()

// Configure the following parameters to write the sample data to Hologres.
df.write.format("hologres") // Set the value to hologres.
  .option("username", "your_username") // The AccessKey ID of your Alibaba Cloud account.
  .option("password", "your_password") // The AccessKey secret of your Alibaba Cloud account.
  .option("endpoint", "Ip:Port") // The IP address and port number of your Hologres instance.
  .option("database", "test_database") // The name of the Hologres database. The name is test_database in this example.
  .option("table", "tb008") // The name of the Hologres table to which you want to write data. The table name is tb008 in this example.
  .option("write_batch_size", 512) // The maximum number of write requests allowed in a batch. For more information, see the parameter description in the "Use Spark to write data to Hologres in real time" section.
  .option("input_data_schema_ddl", df.schema.toDDL) // The data definition language (DDL) statement for DataFrame. This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // The save mode of the Spark DataFrameWriter interface. The value must be Append. This parameter differs from the WRITE_MODE parameter. The value OverWrite is supported for hologres-connector 1.3.3 and later. If you set this parameter to OverWrite, data in the source table is cleared. Proceed with cautions when you use this value.
  .save()
-
-
Consulte los datos de la tabla de destino.
Consulte los datos de la tabla de destino en la consola de Hologres para comprobar la información escrita. La siguiente figura muestra un ejemplo.
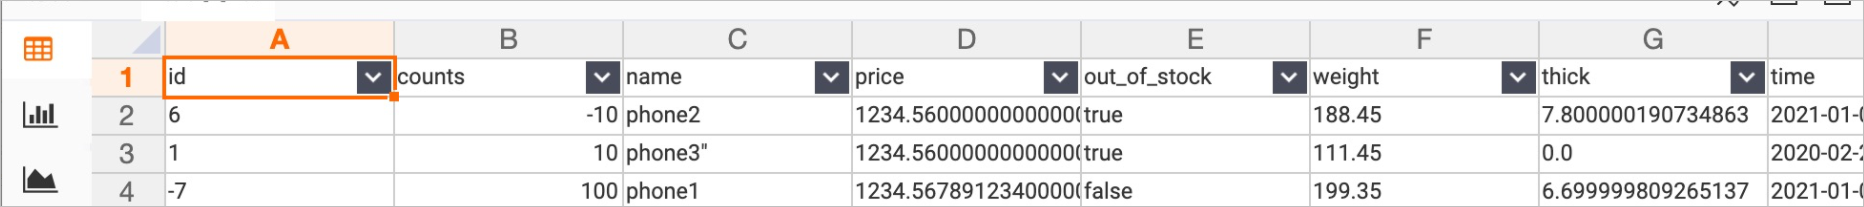
Ejemplo de uso del conector de PySpark para escribir datos en Hologres
-
Inicie PySpark y cargue el conector de PySpark.
pyspark --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Utilice los metadatos para crear un objeto DataFrame y llame al conector para escribir los datos en Hologres. Esta operación es similar a la que se realiza con el Spark connector.
data = [[1, "Elia"], [2, "Teo"], [3, "Fang"]]
df = spark.createDataFrame(data, schema="id LONG, name STRING")
df.show()

df2.write.format("hologres").option(
  "username", "your_username").option(
  "password", "your_password").option(
  "endpoint", "hologres_endpoint").option(
  "database", "test_database").option(
  "table", "tb008").save()
Uso de Spark SQL para cargar un conector y escribir datos en Hologres
Solo el Spark connector para Spark 3 admite este modo.
-
Inicie Spark SQL y cargue el Spark connector.
spark-sql --jars hologres-connector-spark-3.x-1.4.0-SNAPSHOT-jar-with-dependencies.jar -
Ejecute las siguientes instrucciones DDL de Spark SQL para crear una vista CSV y una vista de Hologres, y luego escriba datos en ellas:
CREATE TEMPORARY VIEW csvTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING csv OPTIONS (
  path "resources/customer1.tbl", sep "|"
);

CREATE TEMPORARY VIEW hologresTable (
  c_custkey bigint,
  c_name string,
  c_address string,
  c_nationkey int,
  c_phone string,
  c_acctbal decimal(15, 2),
  c_mktsegment string,
  c_comment string)
USING hologres OPTIONS (
  jdbcurl "jdbc:postgresql://hologres_endpoint/test_database",
  username "your_username",
  password "your_password",
  table "customer_holo_table",
  copy_write_mode "true",
  bulk_load "true",
  copy_write_format "text"
);

-- You cannot write data to specific columns of Hologres views that are created by using SQL statements. For example, you cannot execute the insert into hologresTable(c_custkey) select c_custkey from csvTable statement. When you write data, you must write data to all columns that are declared in the DDL statement. If you want to write data to specific columns, you can declare only these columns when you create the table.
INSERT INTO hologresTable SELECT * FROM csvTable;
Lectura de datos de un origen específico con Spark y escritura en Hologres
-
Lea los datos de un origen específico.
Con Spark puede leer datos de distintos tipos de orígenes. A continuación se muestra cómo leer datos de Hologres o de otro tipo de origen:
-
Leer datos de Hologres
Hologres es compatible con PostgreSQL. Por ello, puede usar Spark para leer datos de Hologres mediante el controlador JDBC de PostgreSQL. El siguiente código de ejemplo sirve únicamente como referencia.
NotaAntes de leer datos de Hologres, descargue el paquete PostgreSQL JDBC JAR desde el sitio web oficial. En este ejemplo se utiliza
postgresql-42.2.18. Luego, ejecute el comando./bin/spark-shell --jars /path/to/postgresql-42.2.18.jaren spark-shell para cargar el paquete JAR de JDBC de PostgreSQL. También puede cargar el paquete JAR de JDBC de PostgreSQL junto con el paquete JAR del Spark connector de Hologres.// Read from some table, for example: tb008 val readDf = spark.read .format("jdbc") // Read Hologres data based on the PostgreSQL JDBC driver. .option("driver","org.postgresql.Driver") .option("url", "jdbc:postgresql://Ip:Por/test_database") .option("dbtable", "tb008") .option("user", "your_username") .option("password", "your_password") .load()Las versiones V1.3.2 y posteriores del Spark connector permiten leer datos de Hologres y optimizan el rendimiento de las lecturas paralelas. A diferencia del controlador JDBC de PostgreSQL, el Spark connector le permite configurar el paralelismo de lectura y admite la fragmentación de datos en Hologres para implementar lecturas paralelas. Esto mejora significativamente el rendimiento. Código de ejemplo:
val spark = SparkSession .builder .appName("ReadFromHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val schema = StructType(Array( StructField("id", LongType), StructField("counts", IntegerType), StructField("name", StringType, false), StructField("price", DecimalType(38, 12)), StructField("out_of_stock", BooleanType) )) val readDf = spark.read .format("hologres") .schema(schema) // Optional. If you do not specify a schema, all fields in the Hologres table are read by default. .option("username", "your_username") .option("password", "your_password") .option("jdbcurl", "jdbc:postgresql://hologres_endpoint/test_db") .option("table", "tb008") .option("scan_parallelism", "10") // The default parallelism for reading data from Hologres. The maximum value is the shard count of the Hologres table. .load() -
Leer datos de otro tipo de origen, como un archivo Parquet
Con Spark también puede leer datos de otros tipos de orígenes, como un archivo Parquet o una tabla de Hive. El siguiente ejemplo proporciona el código correspondiente:
import org.apache.spark.{SparkConf, SparkContext}
import org.apache.spark.sql.hive.HiveContext

val sparkConf = new SparkConf()
val sc = new SparkContext(sparkConf)
val hiveContext = new HiveContext(sc)

// Read from some table, for example: phone
val readDf = hiveContext.sql("select * from hive_database.phone")
-
-
Escriba los datos en Hologres.
import com.alibaba.hologres.spark2.sink.SourceProvider

-- Write to hologres table
df.write
  .format("hologres")
  .option(SourceProvider.USERNAME, "your_username")
  .option(SourceProvider.PASSWORD, "your_password")
  .option(SourceProvider.ENDPOINT, "Ip:Port")
  .option(SourceProvider.DATABASE, "test_database")
  .option(SourceProvider.TABLE, table)
  .option(SourceProvider.WRITE_BATCH_SIZE, 512) -- The maximum number of requests allowed in a batch.
  .option(SourceProvider.INPUT_DATA_SCHEMA_DDL, df.schema.toDDL) -- This parameter is required only for Spark 3.X.
  .mode(SaveMode.Append) // This parameter is required only for Spark 3.X.
  .save()
Escritura de datos en Hologres en tiempo real con Spark
-
Ejecute la siguiente instrucción para crear la tabla donde desea escribir los datos en Hologres:
CREATE TABLE test_table_stream ( value text, count bigint ); -
Lea los datos de su máquina local. Recopile estadísticas de frecuencia de palabras y escríbalas en Hologres en tiempo real. El siguiente ejemplo proporciona el código correspondiente:
-
Código
val spark = SparkSession .builder .appName("StreamToHologres") .master("local[*]") .getOrCreate() spark.sparkContext.setLogLevel("WARN") import spark.implicits._ val lines = spark.readStream .format("socket") .option("host", "localhost") .option("port", 9999) .load() -- Split the lines into words val words = lines.as[String].flatMap(_.split(" ")) -- Generate running word count val wordCounts = words.groupBy("value").count() wordCounts.writeStream .outputMode(OutputMode.Complete()) .format("hologres") .option(SourceProvider.USERNAME, "your_username") .option(SourceProvider.PASSWORD, "your_password") .option(SourceProvider.JDBCURL, "jdbc:postgresql://Ip:Port/dbname") .option(SourceProvider.TABLE, "test_table_stream") .option("batchsize", 1) .option("isolationLevel", "NONE") .option("checkpointLocation", checkpointLocation) .start() .awaitTermination() -
Parámetros
Parámetro
Valor predeterminado
Obligatorio
Descripción
username
Ninguna
Sí
El AccessKey ID de su cuenta de Alibaba Cloud. Obtenga el AccessKey ID en la página Security Management.
Se recomienda configurar variables de entorno y obtener el AccessKey ID y el AccessKey secret a partir de ellas. Esto ayuda a reducir el riesgo de filtraciones.
password
Ninguna
Sí
El AccessKey secret de su cuenta de Alibaba Cloud. Obtenga el AccessKey secret en la página Security Management.
Se recomienda configurar variables de entorno y obtener el AccessKey ID y el AccessKey secret a partir de ellas. Esto ayuda a reducir el riesgo de filtraciones.
table
Ninguna
Sí
El nombre de la tabla de Hologres donde desea escribir los datos.
endpoint
Ninguna
Configure este parámetro o el parámetro JDBCURL.
El endpoint de su instancia de Hologres.
Obtenga el endpoint de su instancia de Hologres en la sección Network Information de la página de detalles de la instancia en la consola de Hologres.
database
Ninguna
Configure este parámetro o el parámetro JDBCURL.
El nombre de la base de datos de Hologres donde reside la tabla de destino.
jdbcurl
Ninguna
Configure solo este parámetro o bien los parámetros ENDPOINT y DATABASE.
La JDBC URL de su instancia de Hologres.
copy_write_mode
true
No
Indica si se escriben los datos en el modo fixed copy. El modo fixed copy es una nueva función admitida en Hologres V1.3. En este modo, los datos se escriben mediante streaming en lugar de por lotes. Por lo tanto, la escritura en modo fixed copy ofrece mayor rendimiento y menor latencia de datos, además de consumir menos recursos de memoria del cliente que la escritura mediante la instrucción INSERT.
NotaSi desea usar el modo fixed copy, la versión del conector debe ser V1.3.0 o posterior, y la versión del motor de Hologres debe ser V1.3.34 o posterior.
copy_write_format
false
No
Indica si se comprueban los datos erróneos. Este parámetro solo surte efecto cuando COPY_WRITE_MODE se establece en true. Si lo establece en true y se generan datos erróneos, el sistema puede identificar la fila cuya escritura falló.
NotaLa comprobación de datos erróneos afecta negativamente el rendimiento de escritura. Se recomienda establecer este parámetro en true solo durante el proceso de solución de problemas.
bulk_load
true
No
Indica si se escriben los datos en Hologres en el modo batch copy. En el modo fixed copy, los datos se escriben mediante streaming.
NotaEn Hologres V2.1 se optimizó el rendimiento de escritura en tablas sin claves primarias. En esta versión, la escritura por lotes en una tabla sin clave primaria no adquiere un bloqueo de tabla, sino un bloqueo de fila. Así, las escrituras por lotes pueden ejecutarse en paralelo con las operaciones realizadas mediante fixed plans. Esto mejora la eficiencia y el paralelismo del procesamiento de datos.
Si la versión del conector es V1.4.0 o posterior, la versión del motor de Hologres debe ser V2.1.0 o posterior.
max_cell_buffer_size
20971520 (20 MB)
No
La longitud máxima de un campo cuando COPY_WRITE_MODE se establece en true.
copy_write_dirty_data_check
false
No
Indica si se comprueban los datos erróneos. Si establece este parámetro en true y se generan datos erróneos, el sistema puede identificar la fila cuya escritura falló. La comprobación de datos erróneos afecta negativamente el rendimiento de escritura. Se recomienda establecer este parámetro en true solo durante el proceso de solución de problemas.
NotaEste parámetro solo surte efecto cuando COPY_WRITE_MODE se establece en true.
copy_write_direct_connect
true para escenarios que permiten conexiones directas
No
Este parámetro solo surte efecto cuando COPY_WRITE_MODE se establece en true. La cantidad de datos que se pueden escribir en modo copy depende del rendimiento del endpoint de VPC. El sistema comprueba si el entorno puede conectarse directamente al nodo FE de Hologres al escribir datos en modo copy. Si el entorno admite la conexión directa al nodo FE de Hologres, se utilizan conexiones directas de forma predeterminada. Si establece este parámetro en false, no se utilizan conexiones directas.
input_data_schema_ddl
Ninguna
Este parámetro es obligatorio para Spark 3.X. Configure el valor del parámetro con el formato
<your_DataFrame>.schema.toDDL.La instrucción DDL para DataFrame en Spark.
write_mode
INSERT_OR_REPLACE
No
La política utilizada para gestionar conflictos de claves primarias. Este parámetro es obligatorio si la tabla de destino tiene una clave primaria. Valores válidos:
INSERT_OR_IGNORE: descarta los datos que intenta escribir si ocurre un conflicto de clave primaria.
INSERT_OR_UPDATE: actualiza las columnas correspondientes en la tabla de destino si ocurre un conflicto de clave primaria.
INSERT_OR_REPLACE: actualiza todas las columnas de la tabla de destino si ocurre un conflicto de clave primaria.
write_batch_size
512
No
La cantidad máxima de solicitudes permitidas en un lote dentro de un hilo para escribir datos. Si la cantidad total de solicitudes PUT alcanza el límite superior especificado por el parámetro write_batch_size después de gestionar los conflictos según el parámetro write_mode, los datos se envían en un lote.
write_batch_byte_size
2 MB
No
La cantidad máxima de bytes permitidos en un lote dentro de un hilo para escribir datos. Si el total de bytes de las solicitudes PUT alcanza el límite superior especificado por el parámetro WRITE_BATCH_BYTE_SIZE después de gestionar los conflictos según el parámetro WRITE_MODE, los datos se envían en un lote.
write_max_interval_ms
10000 ms
No
El intervalo con el que se envían los datos en un lote.
write_fail_strategy
TYR_ONE_BY_ONE
No
La política utilizada para gestionar errores de envío. Si no se puede enviar un lote, Holo Client envía las entradas de datos del lote una por una en el orden especificado. Si una entrada de datos no se puede enviar, Holo Client devuelve un mensaje de error que contiene la información de dicha entrada.
write_thread_size
1
No
La cantidad de hilos paralelos utilizados para escribir datos. Cada hilo ocupa una conexión.
La cantidad total de conexiones que ocupa un trabajo de Spark varía según el paralelismo de Spark. Calcule la cantidad total de conexiones con la siguiente fórmula:
Total number of connections = Value of spark.default.parallelism × Value of WRITE_THREAD_SIZE.dynamic_partition
false
No
Indica si se crea automáticamente una partición cuando los datos se escriben en una tabla principal sin particiones. Valores válidos: true y false. true: se crea automáticamente una partición cuando los datos se escriben en una tabla principal sin particiones.
retry_count
3
No
La cantidad máxima de reintentos permitidos para escribir y consultar datos si ocurre un error de conexión.
retry_sleep_init_ms
1000 ms
No
El tiempo que consumen los reintentos de una solicitud se calcula con la siguiente fórmula: retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
retry_sleep_step_ms
10*1000 ms
No
El tiempo que consumen los reintentos de una solicitud se calcula con la siguiente fórmula: retry_sleep_init_ms + retry_count × retry_sleep_step_ms.
connection_max_idle_ms
60000 ms
No
El tiempo de espera de inactividad para las conexiones utilizadas en la lectura y escritura de datos. Si una conexión permanece inactiva durante un periodo mayor al tiempo de espera especificado, Holo Client libera automáticamente la conexión.
fixed_connection_mode
false
No
Indica si se usan conexiones fijas. En un modo distinto a fixed copy, como el modo INSERT, las escrituras de datos y las consultas puntuales no ocupan conexiones.
NotaLa función de conexión fija se encuentra en versión beta y solo está disponible cuando la versión del conector es V1.2.0 o posterior y la versión del motor de Hologres es V1.3.0 o posterior.
scan_batch_size
256
No
La cantidad de filas que se analizan cada vez que lee datos de Hologres.
scan_timeout_seconds
60
No
El tiempo de espera de la operación de análisis cuando lee datos de Hologres. Unidad: segundos.
scan_parallelism
10
No
La cantidad de fragmentos utilizados para leer datos de Hologres. El valor máximo corresponde a la cantidad de fragmentos de la tabla de Hologres. Durante la ejecución del trabajo, los fragmentos se asignan a las tareas de Spark para la lectura de datos.
-
Asignaciones de tipos de datos
La siguiente tabla describe las asignaciones de tipos de datos entre Spark y Hologres.
|
Tipo de dato de Spark |
Tipo de dato de Hologres |
|
ShortType |
SMALLINT |
|
IntegerType |
INT |
|
LongType |
BIGINT |
|
StringType |
TEXT, JSONB y JSON |
|
DecimalType |
NUMERIC(38, 18) |
|
BooleanType |
BOOL |
|
DoubleType |
DOUBLE PRECISION |
|
FloatType |
FLOAT |
|
TimestampType |
TIMESTAMPTZ |
|
DateType |
DATE |
|
BinaryType |
BYTEA y ROARINGBITMAP |
|
ArrayType(IntegerType) |
int4[] |
|
ArrayType(LongType) |
int8[] |
|
ArrayType(FloatType |
float4[] |
|
ArrayType(DoubleType) |
float8[] |
|
ArrayType(BooleanType) |
boolean[] |
|
ArrayType(StringType) |
text[] |