AnalyticDB for MySQL admite la búsqueda vectorial en datos no estructurados mediante SQL estándar. Almacene los vectores de características junto con las columnas estructuradas, cree un índice de vecino más cercano aproximado (ANN) y ejecute consultas de similitud con L2_DISTANCE, sin necesidad de una base de datos vectorial independiente.
Requisitos previos
El clúster debe ejecutar la versión del kernel 3.1.4.0 o posterior.
La función de índice vectorial es más estable en los clústeres que ejecutan la versión del kernel 3.1.5.16, 3.1.6.8, 3.1.8.6 o una versión posterior.
Si el clúster no ejecuta alguna de las versiones estables listadas, establezca los parámetros CSTORE_PROJECT_PUSH_DOWN y CSTORE_PPD_TOP_N_ENABLE en false antes de usar la función de índice vectorial.
Antes de empezar, asegúrese de contar con lo siguiente:
Un clúster de AnalyticDB for MySQL que ejecute la versión V3.1.4.0 o posterior.
(Recomendado) La versión secundaria 3.1.5.16, 3.1.6.8, 3.1.8.6 o posterior para obtener un rendimiento óptimo en la búsqueda vectorial.
Si el clúster no utiliza una de las versiones secundarias recomendadas, establezca los parámetros CSTORE_PROJECT_PUSH_DOWN y CSTORE_PPD_TOP_N_ENABLE en false antes de usar la búsqueda vectorial. Para consultar la versión secundaria, consulte ¿Cómo consulto la versión de un clúster de AnalyticDB for MySQL? Para actualizar la versión secundaria, póngase en contacto con el soporte técnico.
Funcionamiento
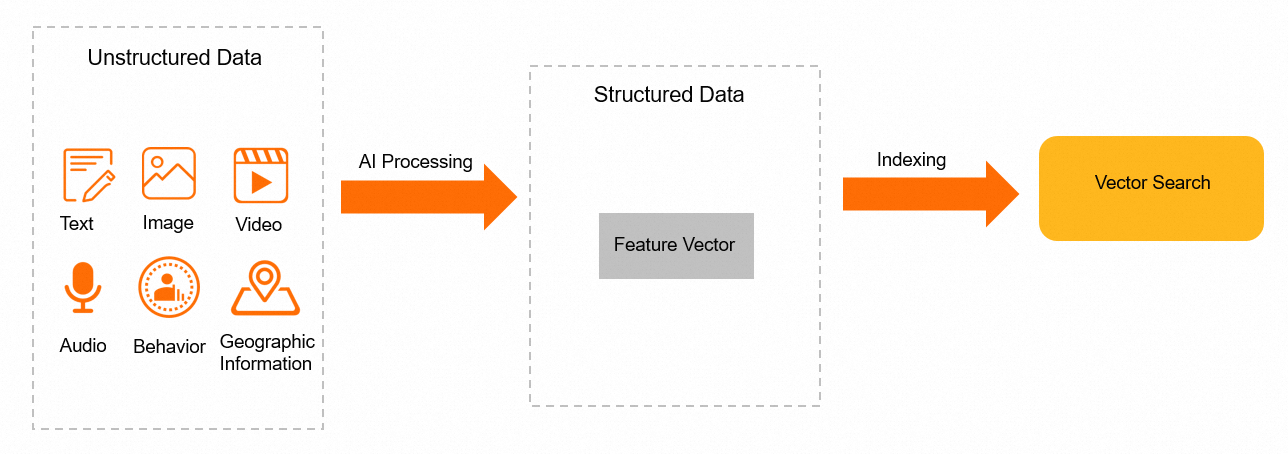
Utilice un modelo de IA para extraer las características de sus datos no estructurados y codifíquelas como arreglos de números flotantes de longitud fija (vectores de características). Almacene esos vectores en AnalyticDB for MySQL junto con las columnas estructuradas.
Al momento de la consulta, pase un vector de consulta a L2_DISTANCE. La base de datos calcula la distancia euclidiana al cuadrado entre el vector de consulta y cada vector almacenado, y luego devuelve las coincidencias más cercanas. Una distancia menor indica mayor similitud.
A continuación se muestra el flujo de trabajo completo:
Cree una tabla con una o más columnas vectoriales (
ARRAY<FLOAT>,ARRAY<BYTE>oARRAY<SMALLINT>).Agregue un índice ANN en cada columna vectorial, ya sea durante la creación de la tabla o con
ALTER TABLE.Inserte filas, incluidos los valores vectoriales.
Ejecute la consulta con
L2_DISTANCEyORDER BY … LIMIT(vecino más cercano k) o agregue un umbral de distancia enWHERE(vecino más cercano por radio).
Conceptos clave
|
Término |
Definición |
|
Vector de características |
Arreglo numérico de longitud fija que representa una entidad en el espacio vectorial. La distancia entre dos vectores mide su similitud. Por ejemplo, un arreglo de números flotantes de 512 dimensiones puede representar un rostro humano. |
|
Índice vectorial (ANN INDEX) |
Índice especializado que acelera la búsqueda aproximada del vecino más cercano en columnas vectoriales. |
|
Vecino más cercano k (KNN) |
Devuelve las k filas cuyos vectores están más cerca de un vector de consulta. Utilice |
|
Vecino más cercano por radio (RNN) |
Devuelve todas las filas cuyos vectores se encuentran dentro de una distancia especificada respecto a un vector de consulta. Utilice |
|
L2_DISTANCE |
Función SQL para la distancia euclidiana al cuadrado: (x₁−y₁)² + (x₂−y₂)² + … + (xₙ−yₙ)². Un valor menor significa que los vectores son más similares. |
Creación de una tabla con un índice vectorial
Defina las columnas vectoriales como ARRAY<FLOAT>, ARRAY<BYTE> o ARRAY<SMALLINT> y agregue las declaraciones ANN INDEX en la misma instrucción CREATE TABLE.
Sintaxis:
ANN INDEX [index_name] (column_name) [algorithm=HNSW_PQ] [distancemeasure=SquaredL2]|
Parámetro |
Descripción |
|
|
Nombre del índice. Consulte Naming limits. |
|
|
Nombre de la columna vectorial. Tipos de datos compatibles: |
|
|
Establézcalo en |
|
|
Establézcalo en |
Ejemplo:
La siguiente instrucción crea una tabla llamada vector con dos columnas vectoriales indexadas: float_feature (ARRAY<FLOAT>, 4 dimensiones) y short_feature (ARRAY<SMALLINT>, 4 dimensiones).
CREATE TABLE vector (
  xid bigint not null,
  cid bigint not null,
  uid varchar not null,
  vid varchar not null,
  wid varchar not null,
  float_feature array < float >(4),
  short_feature array < smallint >(4),
  ANN INDEX idx_short_feature(short_feature),
  ANN INDEX idx_float_feature(float_feature),
  PRIMARY KEY (xid, cid, vid)
) DISTRIBUTED BY HASH(xid);
Adición de un índice vectorial a una tabla existente
Utilice ALTER TABLE para agregar un índice ANN a una columna de una tabla existente.
Sintaxis:
ALTER TABLE table_name ADD ANN INDEX [index_name] (column_name) [algorithm=HNSW_PQ] [distancemeasure=SquaredL2]Ejemplo:
Dada la siguiente tabla (creada sin índices ANN):
CREATE TABLE vector (
  xid BIGINT not null,
  cid BIGINT not null,
  uid VARCHAR not null,
  vid VARCHAR not null,
  wid VARCHAR not null,
  float_feature array < FLOAT >(4),
  short_feature array < SMALLINT >(4),
  PRIMARY KEY (xid, cid, vid)
) DISTRIBUTED BY HASH(xid);
Agregue índices en ambas columnas vectoriales:
ALTER TABLE vector ADD ANN INDEX idx_float_feature(float_feature);
ALTER TABLE vector ADD ANN INDEX idx_short_feature(short_feature);
ALTER TABLE table_name ADD ANN INDEX [index_name] (column_name) [algorithm=HNSW_PQ ] [distancemeasure=SquaredL2]ALTER TABLE table_name ADD ANN INDEX [index_name] (column_name) [algorithm=HNSW_PQ ] [distancemeasure=SquaredL2|CosineSimilarity]Consulta de datos vectoriales
Todos los ejemplos siguientes utilizan L2_DISTANCE para ordenar las filas según su similitud con un vector de consulta.
Inserción de datos de ejemplo:
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (1,2,'A','B','C','[1,1,1,1]','[1.2,1.5,2,3.0]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (2,1,'e','v','f','[2,2,2,2]','[1.5,1.15,2.2,2.7]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (0,6,'d','f','g','[3,3,3,3]','[0.2,1.6,5,3.7]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (5,4,'j','b','h','[4,4,4,4]','[1.0,4.15,6,2.9]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (8,5,'Sj','Hb','Dh','[5,5,5,5]','[1.3,4.5,6.9,5.2]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (5,4,'x','g','h','[3,4,4,4]','[1.0,4.15,6,2.9]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (5,4,'j','r','k','[6,6,4,4]','[1.0,4.15,6,2.9]');
INSERT into vector (xid,cid,uid,vid,wid,short_feature,float_feature) VALUES (5,4,'s','i','q','[2,2,4,4]','[1.0,4.15,6,2.9]');
KNN: devolución de los k vecinos más cercanos
Devuelva las 3 filas de short_feature más cercanas a [1,1,1,1]:
SELECT xid, l2_distance(short_feature, '[1,1,1,1]') as dis FROM vector ORDER BY 2 LIMIT 3;Resultado:
+-------+--------------+
| xid   |   dis        |
+-------+--------------+
| 1     |   0.0        |
+-------+--------------+
| 2     |   4.0        |
+-------+--------------+
| 0     |   16.0       |
+-------+--------------+
KNN con un filtro estructurado
Devuelva las 4 filas más cercanas donde xid = 5 y cid = 4:
SELECT uid, l2_distance(short_feature, '[1,1,1,1]') as dis FROM vector WHERE xid = 5 AND cid = 4 ORDER BY 2 LIMIT 4;Resultado:
+-------+--------------+
| uid   |   dis        |
+-------+--------------+
| s     |   20.0       |
+-------+--------------+
| x     |   31.0       |
+-------+--------------+
| j     |   36.0       |
+-------+--------------+
| j     |   68.0       |
+-------+--------------+
RNN: filtrado por umbral de distancia
Devuelva hasta 3 filas cuya distancia sea menor que 50.0 y donde xid = 5:
SELECT uid, l2_distance(short_feature, '[1,1,1,1]') as dis FROM vector WHERE l2_distance(short_feature, '[1,1,1,1]') < 50.0 AND xid = 5 ORDER BY 2 LIMIT 3;Resultado:
+-------+---------------+
| uid   |   dis         |
+-------+---------------+
| s     |   20.0        |
+-------+---------------+
| x     |   31.0        |
+-------+---------------+
| j     |   36.0        |
+-------+---------------+
Casos de uso
Búsqueda basada en imágenes: codifique imágenes de productos o escenas como vectores para encontrar resultados visualmente similares.
Reconocimiento facial: almacene incrustaciones faciales y compárelas con los rostros de consulta en una base de datos.
Coincidencia de huellas de voz: compare las incrustaciones de voz de los hablantes para autenticación o identificación.
Búsqueda de texto: codifique oraciones con un modelo de lenguaje y recupere pasajes semánticamente similares.
Rendimiento
AnalyticDB for MySQL utiliza una arquitectura de procesamiento masivamente paralelo (MPP) para ofrecer búsquedas vectoriales en milisegundos. A continuación se muestran los resultados de las pruebas de rendimiento con vectores faciales de 512 dimensiones:
|
Escenario |
Volumen de datos |
QPS |
Tiempo de respuesta |
Recuperación |
|
Alta recuperación, carga moderada |
10 mil millones de entradas |
100 |
50 ms |
99% |
|
Alto rendimiento |
200 millones de entradas |
1,000 |
1 s |
99% |
La base de datos admite escrituras en tiempo real con alta concurrencia. Los datos se pueden consultar inmediatamente después de insertarlos.