Los node pools de Container Service for Kubernetes (ACK) admiten la reparación automática personalizada. En los nodos ECS y Lingjun, incluidos los super nodes, ACK detecta los errores de GPU y los errores subyacentes del nodo. Luego los repara con los pasos que usted defina e informa el progreso mediante Kubernetes Events.
Antes de empezar
Tipos de node pool: node pools de Elastic Compute Service (ECS) y node pools de Lingjun, incluidos los super nodes.
Tipos de error: errores de nodo, errores de GPU y errores de sistema y componentes.
-
Dependencia de complementos
Detección de errores: requiere ack-node-problem-detector (NPD) v1.2.36 o posterior para detectar errores de GPU, de sistema, de componentes y de complementos.
Reparación automática: se gestiona mediante node-lifecycle-controller. Actualice a la versión más reciente para obtener las capacidades de reparación más nuevas. Para consultar las instrucciones de actualización, consulte Upgrade the node auto repair add-on.
Diagnóstico automático de errores: compatible solo con los node pools de ECS.
Regiones: no es compatible con las regiones de nube dedicada.
Mecanismo de reparación automática
La reparación automática de nodos supervisa las señales de error que reportan los nodos, como los eventos de CloudMonitor (CMS), los eventos del sistema subyacente y los errores de GPU, de sistema y de componentes que detecta NPD. ACK convierte cada error detectado en un Kubernetes Event y en una Node Condition. Después repara el nodo según las reglas de reparación automática configuradas e informa el progreso mediante Kubernetes Events.
Proceso
Detección de errores: ACK supervisa de forma continua los eventos subyacentes del nodo y las anomalías que reporta NPD. Cuando detecta un error, agrega la Node Condition correspondiente al nodo y genera un plan de reparación.
-
Gestión de errores: ACK ejecuta los pasos de reparación en secuencia según la regla de reparación automática. Cada paso se puede habilitar u omitir. Además, cualquier paso habilitado puede requerir intervención manual; en ese caso, ACK continúa solo después de otorgar la autorización.
Aislamiento del nodo: marca el nodo con errores como Unschedulable para evitar que se programen nuevas cargas de trabajo en él.
Vaciado del nodo: expulsa las cargas de trabajo que se ejecutan en el nodo.
Reparación automática: inicia una acción de reparación, como una reparación de hardware o un reinicio del nodo, según el tipo de error.
Eliminación del aislamiento del nodo: restaura el nodo a un estado Schedulable cuando finaliza la reparación.
Para determinar si una reparación fue exitosa o terminó con errores, consulte Kubernetes Events for node auto repair.
A continuación se muestra el proceso de reparación automática.

ACK gestiona los errores por prioridad: primero repara los errores de tipo reparación con alta prioridad y pospone los de tipo reinicio con baja prioridad hasta que se gestionen todos los de alta prioridad.
Precauciones
Si el clúster ya ejecuta otro software de reparación automática de nodos, evalúe cuidadosamente la configuración antes de usar esta función para evitar conflictos entre varios mecanismos de reparación.
Si se habilita la intervención manual en algún paso de reparación, otorgue la autorización de inmediato. De lo contrario, ACK pausa el paso actual y todos los siguientes, por lo que el nodo podría permanecer en un estado no saludable.
Cuando ocurre un error de tipo nodo en un nodo Lingjun, ACK lo repara durante la etapa de reparación mediante la operación de O&M basada en aprobación de Lingjun. Supervise el estado del nodo Lingjun y su estado de nodo en el clúster de ACK para limitar el impacto en sus cargas de trabajo.
Si el proceso de reparación automática del nodo termina con errores, inicie sesión en el clúster lo antes posible, repare el nodo manualmente y restáurelo a un estado Schedulable. Si necesita ayuda, comuníquese con el soporte técnico.
Después de habilitar la reparación automática de nodos, habilite la gestión de alertas y active los conjuntos de reglas de alerta GPU monitoring and alert rules, Alert Rules for Node Pool O&M Events y Cluster Node Auto Repair Alert Rule Set. Para obtener más información, consulte Configure alerts.
Configurar reglas de reparación automática
Procedimiento
Para configurar y usar la reparación automática de nodos, complete los siguientes pasos:
Configurar reglas de reparación automática: en las configuraciones administradas de un node pool nuevo o existente, cree una regla de reparación automática y especifique los tipos de error y el proceso de reparación. Para obtener más información, consulte Auto repair configuration.
Configurar la limitación y la interrupción (opcional): en las configuraciones administradas, establezca el número máximo de nodos reparados en paralelo y el umbral de interrupción. Esto evita que las operaciones de reparación sobrecarguen el clúster durante errores a gran escala. Para obtener más información, consulte Auto repair throttling and circuit breaking.
Habilitar el diagnóstico automático de errores (opcional, solo para node pools de ECS): en las configuraciones administradas, seleccione Automatic Fault Diagnosis para habilitar el diagnóstico profundo de errores de hardware de GPU. Para obtener más información, consulte Enable automatic fault diagnosis.
Habilitar alertas: active la gestión de alertas y los conjuntos de reglas de alerta para la reparación automática de nodos. Para obtener más información, consulte Configure alerts.
Supervisar y gestionar eventos: siga el progreso de la reparación automática mediante Kubernetes Events (consulte Kubernetes Events for node auto repair). Otorgue la autorización en cuanto ACK la solicite e intervenga manualmente si el proceso termina con errores.
Configuración de la reparación automática
Puede habilitar la reparación automática de nodos y definir reglas de reparación automática cuando cree un node pool o modifique un node pool existente.
Puntos de entrada
Node pool nuevo: cuando cree un node pool, en el área Configure Managed Node Pool, seleccione Custom Node Management. Luego siga las instrucciones en pantalla para habilitar Auto Repair y crear reglas de reparación automática. Para consultar la descripción completa de los elementos de configuración, consulte Create and manage node pools.
Node pool existente: en la lista de node pools, busque el node pool de destino. En la columna Actions, haga clic en
 Enable Managed Node Pool si el modo administrado no está habilitado, o haga clic en Configure Managed Node Pool si el modo administrado ya está habilitado. Después siga las instrucciones en pantalla para crear reglas de reparación automática y habilitar la reparación automática de nodos.
Configurar una regla de reparación automática
Acceder a la página de configuración de reglas: abra el panel Create Self-Healing Rule desde la página de creación o configuración del node pool, o haga clic en Create Self-Healing Rule en la página Self-Healing Rule.
-
Configurar subreglas:
Seleccionar el tipo de error y la acción de reparación: según el tipo de error (errores de nodo, errores de GPU o errores de sistema y componentes), seleccione la acción de reparación correspondiente (consulte Faults).
-
Configurar el proceso de reparación: todos los siguientes pasos admiten intervención manual; en ese caso, ACK ejecuta el paso solo después de otorgar la autorización. Para obtener más información, consulte la descripción en la consola.
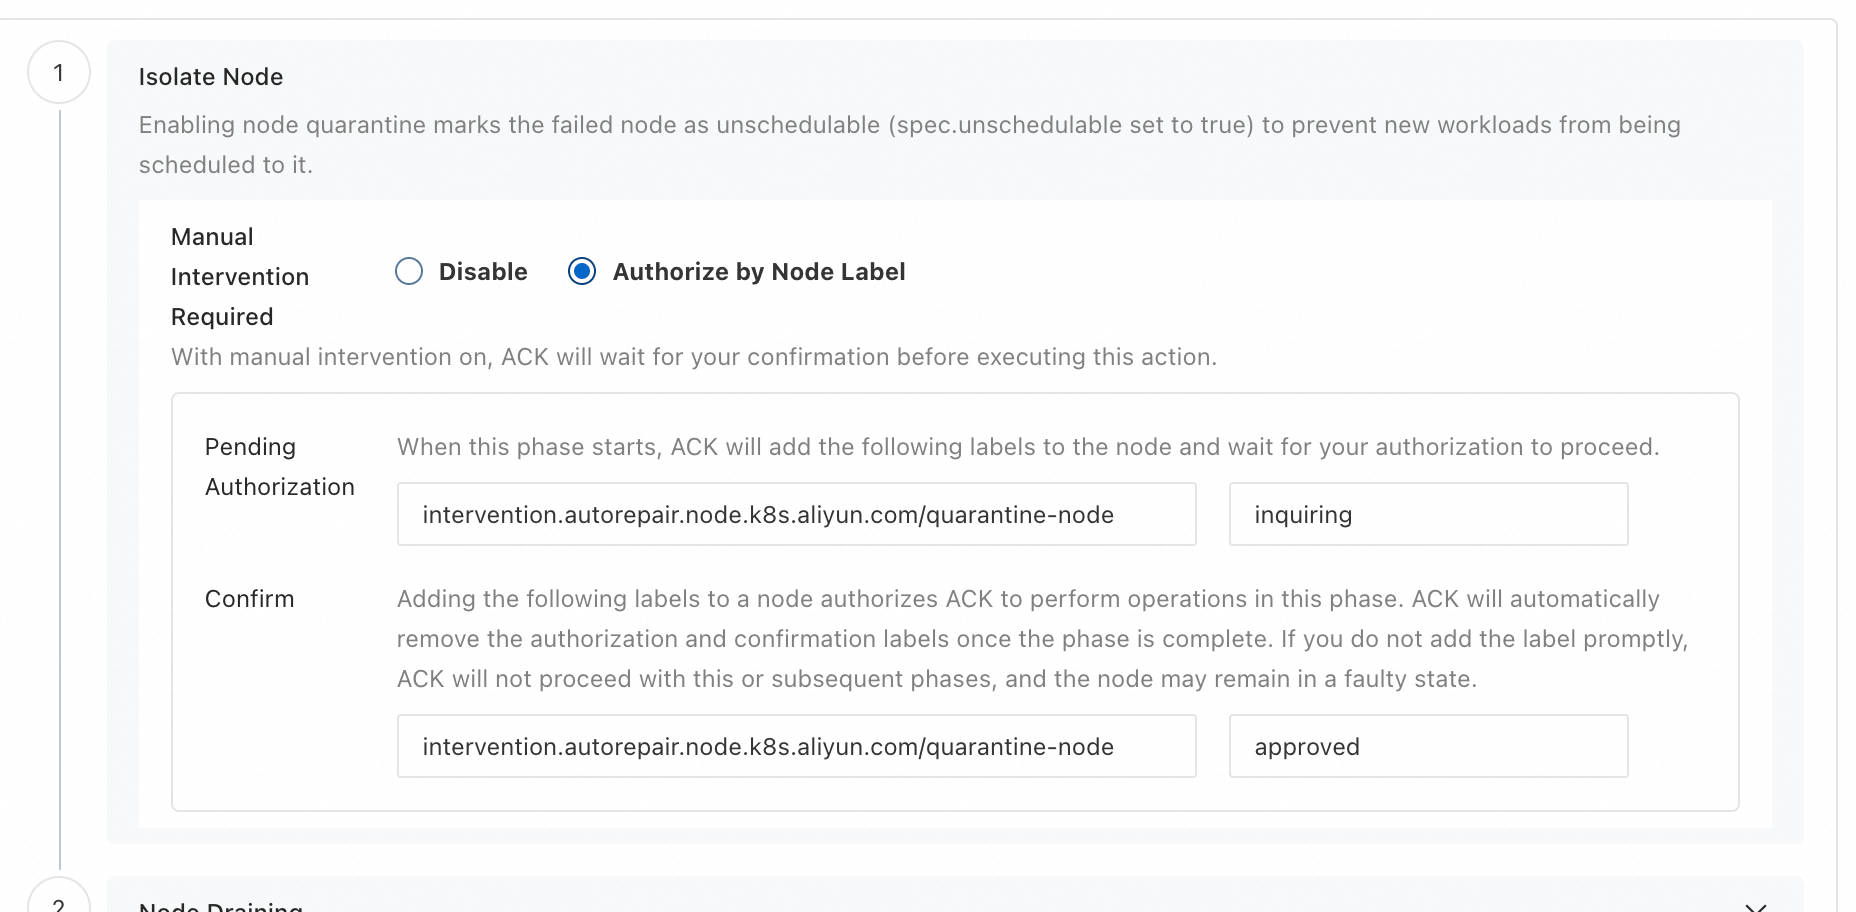
Parámetro
Descripción
Node isolation
Marca el nodo con errores como Unschedulable (
spec.unschedulable=true) para evitar que se programen nuevas cargas de trabajo en él.Node draining
Requiere el aislamiento del nodo. Expulsa las cargas de trabajo del nodo una por una y respeta las restricciones de Pod Disruption Budget (PDB). El tiempo de espera predeterminado es de 300 segundos y se puede configurar. No se expulsan los pods gestionados por un DaemonSet o un OpenKruise Advanced DaemonSet, ni los pods etiquetados con
alibabacloud.com/evict-pod=skip. El proceso avanza al siguiente paso cuando transcurre el tiempo de espera.Automatic repair
Ejecuta la acción de reparación que corresponde al tipo de error (para obtener más información, consulte Faults).
Node isolation removal
Requiere el aislamiento del nodo. Vuelve a hacer que el nodo sea Schedulable (
spec.unschedulable=false). Si el nodo ya era Unschedulable antes de iniciar el proceso de reparación, este paso no lo restaura a un estado Schedulable.
Limitación e interrupción de la reparación automática
Después de seleccionar Custom Node Management y habilitar Auto Repair en la página Configure Managed Node Pool, la política de limitación e interrupción de la reparación automática entra en vigor con su configuración predeterminada.
Política predeterminada
De forma predeterminada, si varios nodos de un node pool presentan anomalías al mismo tiempo, ACK los repara uno por uno y no activa la interrupción.
Modificar la política predeterminada
Si la política predeterminada no cumple con sus requisitos, haga clic en Modify Auto Repair Throttling and Circuit Breaking Policy y configure los siguientes parámetros:
|
Parámetro |
Descripción |
|
Maximum number of nodes repaired in parallel |
El número máximo de nodos que ACK repara al mismo tiempo cuando muchos nodos del node pool presentan anomalías. |
|
Circuit breaking condition |
Cuando la cantidad de nodos con errores supera este umbral, la reparación automática entra en estado de interrupción y deja de iniciar nuevas operaciones de reparación. |
Umbral de interrupción: debe ser mayor o igual que el límite de reparación en paralelo para evitar que las reparaciones se detengan de forma prematura.
Límite de reparación en paralelo: para la recuperación de un super node, ACK repara todos los nodos secundarios de forma simultánea. Este límite debe ser, como mínimo, la cantidad de nodos secundarios de un solo super node.
Habilitar el diagnóstico automático de errores
Después de habilitar el diagnóstico automático de errores, ACK usa el sondeo del lado del nodo ack-node-problem-detector para detectar posibles anomalías y ejecutar un diagnóstico profundo del hardware de GPU. Cuando se confirma una anomalía, ACK genera alertas mediante Kubernetes Events, Node Conditions y eventos del sistema de ECS. Combine estas alertas con las reglas de reparación automática para que ACK responda automáticamente.
Esta opción aplica solo a los node pools de ECS.
Cómo habilitarlo
Node pool nuevo
Cuando cree un node pool, en el área Configure Managed Node Pool, seleccione Custom Node Management y luego seleccione la casilla de verificación Automatic Fault Diagnosis.
Node pool existente
Para node pools administrados: en la lista de node pools, haga clic en
> Configure Managed Node Pool en la columna Actions del node pool de destino. En el cuadro de diálogo Configure Managed Node Pool, seleccione la casilla de verificación Auto Fault Diagnosis.Para node pools no administrados: en la lista de node pools, haga clic en
> Enable Managed Node Pool en la columna Actions del node pool de destino. En el cuadro de diálogo Enable Managed Node Pool, seleccione Custom Node Management y luego seleccione la casilla de verificación Auto Fault Diagnosis.
Los siguientes elementos de error de NPD activan un diagnóstico profundo de ECS:
|
Elemento de error |
Descripción |
|
|
Double Bit ECC Error (DBE). Este evento se registra cuando la GPU detecta un error no corregible. |
|
|
Detención del microcontrolador interno de la GPU. |
|
|
Error de NVLink. |
|
|
La GPU se desconectó del bus. |
|
|
Context Switch Timeout Error. |
|
|
Se produce un tiempo de espera mientras se aguarda la respuesta del núcleo GSP a un mensaje RPC. |
|
|
Se produce un error en el código que se ejecuta en el núcleo GSP de la GPU. |
|
|
NVLink: RLW Error. |
|
|
GPU Recovery Action Changed. |
|
|
El cable de alimentación externo del dispositivo no está conectado correctamente. |
Configurar alertas
Después de habilitar la reparación automática de nodos, habilite la gestión de alertas y active los siguientes conjuntos de reglas de alerta: GPU monitoring and alert rules, Alert Rules for Node Pool O&M Events y Cluster Node Auto Repair Alert Rule Set. Configure un grupo de alertas o un contacto dedicado para recibir notificaciones de inmediato cuando ocurra una excepción.
Para obtener información sobre cómo habilitar los conjuntos de reglas, consulte ACK alert management.
Descripción de las alertas
Los conjuntos de reglas de alerta incluyen los siguientes elementos de alerta relacionados con la reparación automática de nodos:
|
Elemento de alerta |
Descripción |
|
Underlying event conversion alert |
Se activa cuando los eventos subyacentes del nodo (eventos de CloudMonitor de Lingjun y eventos del sistema de ECS) se convierten en Node Conditions y Kubernetes Events. Así puede detectar a tiempo las anomalías de hardware y de sistema del nodo. Para consultar la asignación completa, consulte Underlying event to Node Condition conversion. |
|
GPU monitoring alert |
Se activa cuando NPD detecta una anomalía en un dispositivo GPU. Para consultar los elementos de error específicos y las acciones de corrección, consulte GPU faults. |
|
Overall auto repair progress alert |
Informa el progreso general del proceso de reparación automática del nodo, incluidos los resultados de los pasos Node isolation, Node draining, Automatic repair y Node isolation removal. Para consultar los eventos de cada paso, consulte Kubernetes Events for node auto repair. |
|
Auto repair summary for cluster node pools |
Resume el estado de reparación automática de cada node pool del clúster a las 10:00 y a las 18:00 hora local todos los días. El resumen destaca los nodos que esperan aprobación y los nodos en estado Unschedulable. También proporciona comandos de consulta listos para ejecutar, de modo que pueda responder a tiempo. |
Actualizar el complemento de reparación automática de nodos
La reparación automática de nodos funciona mediante el complemento node-lifecycle-controller. Los nuevos tipos de error, acciones de reparación y elementos de alerta requieren una versión posterior, por lo que debe actualizar el complemento a la versión más reciente.
Inicie sesión en la consola de ACK. En el panel de navegación izquierdo, abra el clúster de destino.
En el panel de navegación izquierdo de la página de gestión del clúster, haga clic en Components and Add-ons.
-
Busque y encuentre el complemento
node-lifecycle-controller. Si hay una nueva versión disponible, haga clic en Upgrade y confirme en el cuadro de diálogo.Para conocer más operaciones con complementos, consulte Components.
Errores
A continuación se presentan tablas que describen las Node Conditions que activan la reparación automática, las acciones de corrección y los criterios de recuperación para cada tipo de error.
Errores de nodo
Aplica a anomalías de hardware subyacente y errores de tipo reinicio en nodos ECS y Lingjun, incluidos los super nodos.
Lingjun
Nombre del error | Nombre del evento subyacente | Node Condition de Kubernetes | Descripción | Acción de corrección | Criterios de recuperación |
El nodo Lingjun requiere reparación debido a una anomalía de hardware subyacente |
resourceType: Node |
| El nodo Lingjun presenta un error de hardware y requiere reparación. Esta reparación puede provocar la pérdida de datos en los discos locales del nodo. | Reparar el nodo Lingjun Importante La reparación de un nodo Lingjun puede provocar la pérdida de datos en sus discos locales. Haga una copia de seguridad de sus datos por adelantado. Si los directorios del entorno de ejecución de contenedores y de kubelet están montados en un disco local, elimine el nodo de la lista de nodos del clúster de ACK y vuelva a agregarlo cuando finalice la reparación. | Se cumplen ambas condiciones siguientes:
|
El nodo Lingjun requiere un reinicio debido a una anomalía subyacente |
resourceType: Node |
| El nodo Lingjun presenta un error. Reinicie el nodo lo antes posible para intentar repararlo. | Reiniciar el nodo | Se cumplen ambas condiciones siguientes:
|
El nodo Lingjun requiere reparación debido a una anomalía de hardware subyacente (afectado por un super nodo) |
resourceType: HyperNode |
| El super nodo Lingjun presenta un error de hardware que requiere reparación. Autorice la reparación lo antes posible. ACK inicia un flujo de reparación automática independiente para cada nodo secundario del super nodo. Cuando todos los procesos de reparación de los nodos secundarios llegan al paso de reparación, ACK solicita una única autorización para reparar todo el super nodo. | Reparar el nodo Lingjun Importante La reparación de un nodo Lingjun puede provocar la pérdida de datos en sus discos locales. Haga una copia de seguridad de sus datos por adelantado. Si los directorios del entorno de ejecución de contenedores y de kubelet están montados en un disco local, elimine el nodo de la lista de nodos del clúster de ACK y vuelva a agregarlo cuando finalice la reparación. | Se cumplen ambas condiciones siguientes:
|
El nodo Lingjun requiere un reinicio debido a una anomalía subyacente (afectado por un super nodo) |
resourceType: HyperNode |
| El super nodo Lingjun presenta un error. Autorice la reparación lo antes posible. ACK inicia un flujo de reparación automática independiente para cada nodo secundario del super nodo. Cuando todos los procesos de reparación de los nodos secundarios llegan al paso de reparación, ACK solicita una única autorización para reparar todo el super nodo. | Reiniciar el nodo | Se cumplen ambas condiciones siguientes:
|
ECS
Nombre del error | Nombre del evento subyacente | Node Condition de Kubernetes | Descripción | Acción de corrección | Criterios de recuperación |
Redespliegue de instancia obligatorio por mantenimiento del sistema (Scheduled) |
|
| Alibaba Cloud detectó un riesgo potencial de software o hardware en el host subyacente de la instancia ECS. Esto podría requerir un redespliegue de la instancia, aunque aún no constituye un error. Inicie el redespliegue de inmediato para mitigar el riesgo. De lo contrario, ECS lo activará entre 24 y 48 horas después. Para más información, consulte Overview of ECS system events. | Redesplegar el nodo Importante Los datos del disco local podrían perderse durante el redespliegue del nodo. Haga una copia de seguridad de sus datos por adelantado. | Se cumplen ambas condiciones siguientes:
|
Redespliegue de instancia obligatorio por mantenimiento del sistema (Inquiring) |
|
| Alibaba Cloud detectó un riesgo potencial de software o hardware en el host subyacente de la instancia ECS. Esto podría requerir un redespliegue de la instancia, aunque aún no constituye un error. Inicie el redespliegue de inmediato para mitigar el riesgo. Para más información, consulte Overview of ECS system events. | Redesplegar el nodo Importante Los datos del disco local podrían perderse durante el redespliegue del nodo. Haga una copia de seguridad de sus datos por adelantado. | Se cumplen ambas condiciones siguientes:
|
Reinicio de instancia obligatorio por mantenimiento del sistema (Scheduled) |
|
| Alibaba Cloud detectó un riesgo potencial de software o hardware en el host subyacente de la instancia ECS. Esto podría requerir un reinicio de la instancia, aunque aún no constituye un error. Inicie el reinicio de inmediato para mitigar el riesgo. De lo contrario, ECS lo activará entre 24 y 48 horas después. Para más información, consulte Overview of ECS system events. | Reiniciar el nodo | Se cumplen ambas condiciones siguientes:
|
Reinicio de instancia obligatorio por mantenimiento del sistema (Inquiring) |
|
| Alibaba Cloud detectó un riesgo potencial de software o hardware en el host subyacente de la instancia ECS. Esto podría requerir un reinicio de la instancia, aunque aún no constituye un error. Inicie el reinicio de inmediato para mitigar el riesgo. Para más información, consulte Overview of ECS system events. | Reiniciar el nodo | Se cumplen ambas condiciones siguientes:
|
Para ver la correspondencia completa entre eventos subyacentes, Node Conditions y Events de Kubernetes, consulte Underlying event to Node Condition conversion.
Errores de GPU
La detección de estos errores depende del complemento NPD. Todos los errores de GPU comparten los mismos criterios de recuperación: el estado del nodo es Ready y la Node Condition que los activó se resolvió.
Lingjun
Nombre del error | Node Condition de Kubernetes | Descripción | Acción de corrección |
|
| Double Bit ECC Error (DBE). Este evento se registra cuando la GPU detecta un error no corregible. | Reiniciar el nodo |
|
| Detención del microcontrolador interno de la GPU. | Reiniciar el nodo |
|
| El controlador de la GPU detecta un error no corregible en la memoria de la GPU. | Reiniciar el nodo |
|
| El controlador de la GPU detecta un error no corregible en la memoria de la GPU y la supresión falló. | Reiniciar el nodo |
|
| Se produce un error en el código que se ejecuta en el núcleo GSP de la GPU. | Reiniciar el nodo |
|
| Fallo de página en la memoria de la GPU. | Reiniciar el nodo |
|
| La GPU tiene páginas retiradas en estado pendiente. | Reiniciar el nodo |
|
| La reasignación de filas está pendiente y se ejecutará en el próximo reinicio de la GPU. | Reiniciar el nodo |
|
| Se agota el tiempo de espera mientras se aguarda la respuesta del núcleo GSP a un mensaje RPC. | Reiniciar el nodo |
Todos los errores de GPU se corrigen al reiniciar el nodo. Si un error de GPU coincide con un evento del sistema Lingjun que requiere reparación, ACK no reinicia el nodo. Un reinicio durante la reparación podría provocar la pérdida de datos en el disco local y hacer que el proceso de reparación automática termine con errores. Configure una regla de reparación automática independiente para los errores de tipo reparación y cubra este escenario. Para más información, consulte Lingjun node requires repair due to an underlying hardware anomaly .
ECS
Nombre del error | Node Condition de Kubernetes | Descripción | Acción de corrección |
|
| Double Bit ECC Error (DBE). Este evento se registra cuando la GPU detecta un error no corregible. | Reiniciar el nodo |
|
| Detención del microcontrolador interno de la GPU. | Reiniciar el nodo |
|
| El controlador de la GPU detecta un error no corregible en la memoria de la GPU. | Reiniciar el nodo |
|
| El controlador de la GPU detecta un error no corregible en la memoria de la GPU y la supresión falló. | Reiniciar el nodo |
|
| Se produce un error en el código que se ejecuta en el núcleo GSP de la GPU. | Reiniciar el nodo |
|
| Fallo de página en la memoria de la GPU. | Reiniciar el nodo |
|
| La GPU tiene páginas retiradas en estado pendiente. | Reiniciar el nodo |
|
| La reasignación de filas está pendiente y se ejecutará en el próximo reinicio de la GPU. | Reiniciar el nodo |
|
| Se agota el tiempo de espera mientras se aguarda la respuesta del núcleo GSP a un mensaje RPC. | Reiniciar el nodo |
Errores del sistema y de componentes
La detección de estos errores depende del complemento NPD.
Nombre del error | Node Condition de Kubernetes | Descripción | Acción de corrección | Umbral de detección de errores | Criterios de recuperación |
El proceso de sincronización de hora del nodo presenta anomalías |
| El proceso de sincronización de hora (ntpd o chronyd) presenta anomalías. | Inicie sesión en el nodo y ejecute los comandos de reparación Nota Si habilita la opción que permite reiniciar nodos durante la etapa Automatic repair, ACK intentará reiniciar el nodo si la anomalía persiste después de ejecutar la acción de reparación automática. | 10 s | El estado del nodo es |
El entorno de ejecución de contenedores del nodo no está disponible |
| El entorno de ejecución de contenedores (containerd o Docker Engine) se detuvo y el nodo no está disponible. | Inicie sesión en el nodo y ejecute los comandos de reparación Nota Si habilita la opción que permite reiniciar nodos durante la etapa Automatic repair, ACK intentará reiniciar el nodo si la anomalía persiste después de ejecutar la acción de reparación automática. | 90 s | El estado del nodo es |
La unidad systemd del nodo presenta anomalías |
| El estado de systemd presenta anomalías, lo que impide iniciar o destruir contenedores. | Reiniciar el nodo | 90 s | El estado del nodo es |
El nodo se encuentra en estado NotReady |
| kubelet se detuvo o su latido presenta anomalías, lo que hace que el nodo pase al estado NotReady. | Inicie sesión en el nodo y ejecute los comandos de reparación Nota Si habilita la opción que permite reiniciar nodos durante la etapa Automatic repair, ACK intentará reiniciar el nodo si la anomalía persiste después de ejecutar la acción de reparación automática. | 180 s | En tres sondeos consecutivos, el estado del nodo es |
El sistema de archivos (FS) del nodo se encuentra en estado de solo lectura |
| El sistema de archivos del nodo pasó a modo de solo lectura. | Reiniciar el nodo | 90 s | El estado del nodo es |
Conversión de eventos subyacentes a Node Conditions
ACK convierte los eventos subyacentes que generan los nodos Lingjun, los super nodos Lingjun y los nodos ECS en las Node Conditions y los Kubernetes Events correspondientes. Las tablas de esta sección muestran el mapeo completo de estados para facilitar la resolución de problemas. Para conocer las fallas que activan la reparación automática, sus acciones de remediación y los criterios de recuperación, consulte Faults.
Los eventos subyacentes se asignan a las Node Conditions mediante los siguientes campos:
Type: identifica el tipo de falla.Reason: identifica la fase actual del evento.
Orígenes de los eventos subyacentes
La reparación automática de nodos de ACK convierte eventos subyacentes de dos orígenes: los eventos de CloudMonitor que publica el plano de control de Lingjun y los eventos del sistema que publica ECS.
Eventos de Cloud Monitor de Lingjun
El plano de control de Lingjun publica las anomalías de hardware y del sistema de los nodos bare metal de Lingjun como eventos de CloudMonitor. Un evento pasa de Inquiring a Executing y después a Executed o Terminated. ACK extrae estos eventos periódicamente e identifica su tipo. Por ejemplo, Node.HardwareFault.HOST indica que se requiere una reparación, mientras que Node.FaultNeedReboot.HOST señala que es necesario reiniciar el nodo. Posteriormente, los convierte en las Node Conditions correspondientes.
El siguiente diagrama de flujo toma como ejemplo el evento de CloudMonitor Node.HardwareFault.HOST, que corresponde a una falla de hardware en un nodo Lingjun:

Eventos del sistema de ECS
Los nodos ECS reutilizan el framework de eventos del sistema de ECS. El ciclo de vida del evento incluye los siguientes estados: Inquiring, Scheduled, Executing, Executed, Avoided, Failed y Canceled. ACK llama a la API de eventos del sistema de ECS para obtener los eventos de mantenimiento de la instancia, como SystemMaintenance.Reboot y SystemMaintenance.Redeploy, y los asigna a la Node Condition correspondiente del nodo.
El siguiente diagrama de flujo describe los cambios de estado de un evento de mantenimiento de reinicio SystemMaintenance.Reboot desde su estado inicial Inquiring:

Conversión de eventos subyacentes para nodos Lingjun regulares
Cada evento subyacente de un nodo Lingjun regular se convierte en la Node Condition y el Kubernetes Event correspondientes de ese nodo dentro del clúster.
Estado del evento | Descripción | Node Condition | Kubernetes Event |
resourceType: Node | Se está comprobando una falla de hardware en el nodo. |
|
|
resourceType: Node | Comenzó el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: Node | Finalizó el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: Node | Se canceló el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: Node | Se está comprobando una falla que requiere reiniciar el nodo. |
|
|
resourceType: Node | Comenzó el reinicio del nodo para corregir una falla. |
|
|
resourceType: Node | Finalizó el reinicio del nodo para corregir una falla. |
|
|
resourceType: Node | Se canceló el mantenimiento de una falla que requiere reiniciar el nodo. |
|
|
Conversión de eventos subyacentes para super nodos Lingjun
Cada evento subyacente de un super nodo Lingjun se convierte en las Node Conditions y los Kubernetes Events correspondientes de todos los nodos secundarios que pertenecen a ese super nodo.
Estado del evento | Descripción | Node Condition | Kubernetes Event |
resourceType: HyperNode | Se está comprobando una falla de hardware en el nodo. |
|
|
resourceType: HyperNode | Comenzó el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: HyperNode | Finalizó el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: HyperNode | Se canceló el mantenimiento por una falla de hardware en el nodo. |
|
|
resourceType: HyperNode | Se está comprobando una falla que requiere reiniciar el nodo. |
|
|
resourceType: HyperNode | Comenzó el reinicio del nodo para corregir una falla. |
|
|
resourceType: HyperNode | Finalizó el reinicio del nodo para corregir una falla. |
|
|
resourceType: HyperNode | Se canceló el mantenimiento de una falla que requiere reiniciar el nodo. |
|
|
Conversión de eventos de mantenimiento subyacentes para nodos ECS
ACK convierte los eventos de mantenimiento del sistema de los nodos ECS en las Node Conditions y los Kubernetes Events correspondientes.
Estado del evento | Descripción | Node Condition | Kubernetes Event |
| Se está comprobando un reinicio de instancia por mantenimiento del sistema. |
|
|
| Se programó un reinicio de instancia por mantenimiento del sistema. |
|
|
| Se está ejecutando un reinicio de instancia por mantenimiento del sistema. |
|
|
| Finalizó el reinicio de instancia por mantenimiento del sistema. |
|
|
| Se evitó el reinicio de instancia por mantenimiento del sistema. |
|
|
| El reinicio de instancia por mantenimiento del sistema finalizó con errores. |
|
|
| Se canceló el reinicio de instancia por mantenimiento del sistema porque se mitigó el riesgo. |
|
|
| Se está comprobando un redespliegue de instancia por mantenimiento del sistema. |
|
|
| Se programó un redespliegue de instancia por mantenimiento del sistema. |
|
|
| Se está ejecutando un redespliegue de instancia por mantenimiento del sistema. |
|
|
| Finalizó el redespliegue de instancia por mantenimiento del sistema. |
|
|
| Se evitó el redespliegue de instancia por mantenimiento del sistema. |
|
|
| Se canceló el redespliegue de instancia por mantenimiento del sistema. |
|
|
Kubernetes Events para la reparación automática de nodos
Cuando se habilita el modo administrado y se asocia una regla de reparación automática a un node pool, ACK convierte los eventos de falla del nodo en Kubernetes Events y Node Conditions. Además, informa el avance del plan de reparación mediante Kubernetes Events. Para consultar estos eventos, ejecute kubectl describe node <node-name> o kubectl get events.
Comprobar si la reparación automática fue correcta
La reparación automática finaliza cuando el estado del nodo vuelve a Ready, se elimina la Node Condition que la activó (o se cumplen los criterios de éxito específicos de la falla) y se genera un evento RepairPlanCompleted con un mensaje de éxito. Si aparece un evento NodeNotRecovery o RepairPlanFailed, el nodo no se recuperó. En este caso, inicie sesión en el clúster y repare el nodo manualmente tal como se describe en Precautions.
Eventos comunes del proceso de reparación automática
A continuación se describen los Kubernetes Events que ACK genera durante el proceso de reparación automática.
|
Evento (Reason) |
Descripción |
|
|
Se detectó un evento de falla en un nodo Lingjun o se actualizó el estado de un evento de falla. |
|
|
Se detectó un evento de falla en un super nodo Lingjun o se actualizó el estado de un evento de falla. |
|
|
Se detectó un evento de falla en un nodo ECS o se actualizó el estado de un evento de falla. |
|
|
Se creó un plan de reparación. |
|
|
El paso actual requiere autorización manual. El mensaje del evento describe la operación por autorizar y el procedimiento para hacerlo. |
|
|
Se agregó la etiqueta de autorización a las etiquetas del nodo. |
|
|
Se actualizó el estado del plan de reparación. Este evento registra el paso actual y su resultado. |
|
|
Se autorizó al plano de control de Lingjun para ejecutar la reparación. |
|
|
Una vez terminada la reparación, se comprueba el estado del nodo cada 30 minutos. Este evento se activa si el nodo no se recuperó. |
|
|
Finalizó el plan de reparación. El mensaje del evento indica si la reparación se completó correctamente o con errores. |
|
|
La reparación automática de un evento de super nodo espera a que todos los nodos secundarios de ese super nodo entren en la fase de reparación. |
|
|
La cantidad de nodos con fallas en el node pool supera el umbral de corte de circuito. La reparación automática entra en estado de corte de circuito y deja de iniciar nuevas operaciones de reparación. |
|
|
La cantidad de nodos con fallas que se reparan en paralelo en el node pool alcanzó el límite máximo. |
|
|
Se recuperó la falla del nodo y la autocomprobación se completó correctamente. |
Eventos para escenarios especiales
A continuación se describen los Kubernetes Events que ACK genera en escenarios especiales.
|
Evento (Reason) |
Descripción |
|
|
El plan de reparación anterior se completó correctamente, pero el tipo de falla actual es distinto. El sistema espera un periodo de enfriamiento de 10 minutos antes de crear un nuevo plan de reparación. |
|
|
El proceso de reparación automática más reciente gestionó la falla actual correctamente, pero el nodo no se recuperó. Se requiere solución de problemas manual. |
|
|
El plan de reparación de la falla actual finalizó con errores. El nodo sigue sin recuperarse y requiere solución de problemas manual. |
|
|
La actualización del estado del plan de reparación finalizó con errores. |
|
|
No se pudo establecer la etiqueta de autorización y se canceló el proceso de reparación automática. |
|
|
El estado actual de la instancia no cumple los requisitos de la acción de reparación, por lo que se omite temporalmente la reparación automática. |