
Cree IA/aprendizaje automático en Kubernetes
Cloud-native AI proporciona un conjunto de funciones y servicios esenciales para ayudar a los clientes a crear una plataforma de IA, acelerar las cargas de trabajo de IA y simplificar MLOps.
Escalabilidad de recursos
Mejora la utilización de GPU y CPU y aumenta la escalabilidad de los recursos heterogéneos.
Programación eficiente
Programa tareas de IA y de Big Data de manera eficiente y ofrece asistencia de extremo a extremo para todo el proceso de producción de IA.
Acceso acelerado a datos
Mejora el rendimiento de acceso a datos e integra fuentes de datos heterogéneas.
Observabilidad
Admite diversos métodos para observar tareas, cuotas de usuario y recursos.
Flexibilidad y extensibilidad
Le permite crear una plataforma cloud-native de IA personalizada mediante la modificación de la arquitectura extensible basada en componentes.
Kubernetes estándar
Se ejecuta en Kubernetes estándar y es compatible con nubes públicas, Apsara Stack, nubes híbridas y clusters edge de ACK.
Características
Utilización eficiente de recursos heterogéneos
Admite la programación de GPU, el uso compartido de GPU y el aislamiento de memoria. Puede configurar diversas políticas para asignar GPU y monitorear el consumo de recursos de GPU desde múltiples dimensiones.
Mejor rendimiento de acceso a datos
Separa la computación y el almacenamiento. Para acelerar el acceso a datos, Fluid abstrae los datos de las aplicaciones de IA cloud-native y Big Data. Fluid también mejora el aislamiento de seguridad de los datos y elimina los silos de datos causados por los distintos tipos de almacenamiento.
Programación de tareas de IA
Admite diversas políticas de programación (como gang scheduling, programación de capacidad y binpack scheduling) para satisfacer los requisitos de las tareas de IA y mejorar la utilización de recursos del cluster.
Escalado automático de recursos heterogéneos
Realiza una redistribución inteligente de cargas para evitar el desperdicio de recursos de la nube. Cloud-native AI también admite el entrenamiento elástico de modelos y la inferencia basada en modelos.
Observabilidad de tareas, usuarios y recursos del cluster
Proporciona paneles de control de monitoreo para tareas, cuotas de usuario y recursos del cluster que le ayudan a evaluar las entradas y salidas.
Escenarios

Beneficios
-
Asignación de recursos con base en grupos de proyectos
Puede dividir a los miembros del proyecto en grupos aislados. Luego, puede asignar y aislar recursos por grupo, o administrar los permisos de diferentes grupos.
-
Aislamiento y uso compartido entre usuarios
Puede asignar recursos del cluster a grupos de usuarios con base en sus requisitos empresariales. También puede administrar los permisos de los usuarios de cada grupo. Los permisos incluyen los permisos de lectura y escritura de los usuarios sobre las tareas y los permisos de lectura y escritura de las tareas sobre los datos.
-
Cuotas elásticas
Puede utilizar grupos de cuotas elásticas para la programación de capacidad, que permiten compartir recursos y asignarlos adecuadamente a los usuarios. Esto mejora la utilización general de recursos de los clusters.
Beneficios
-
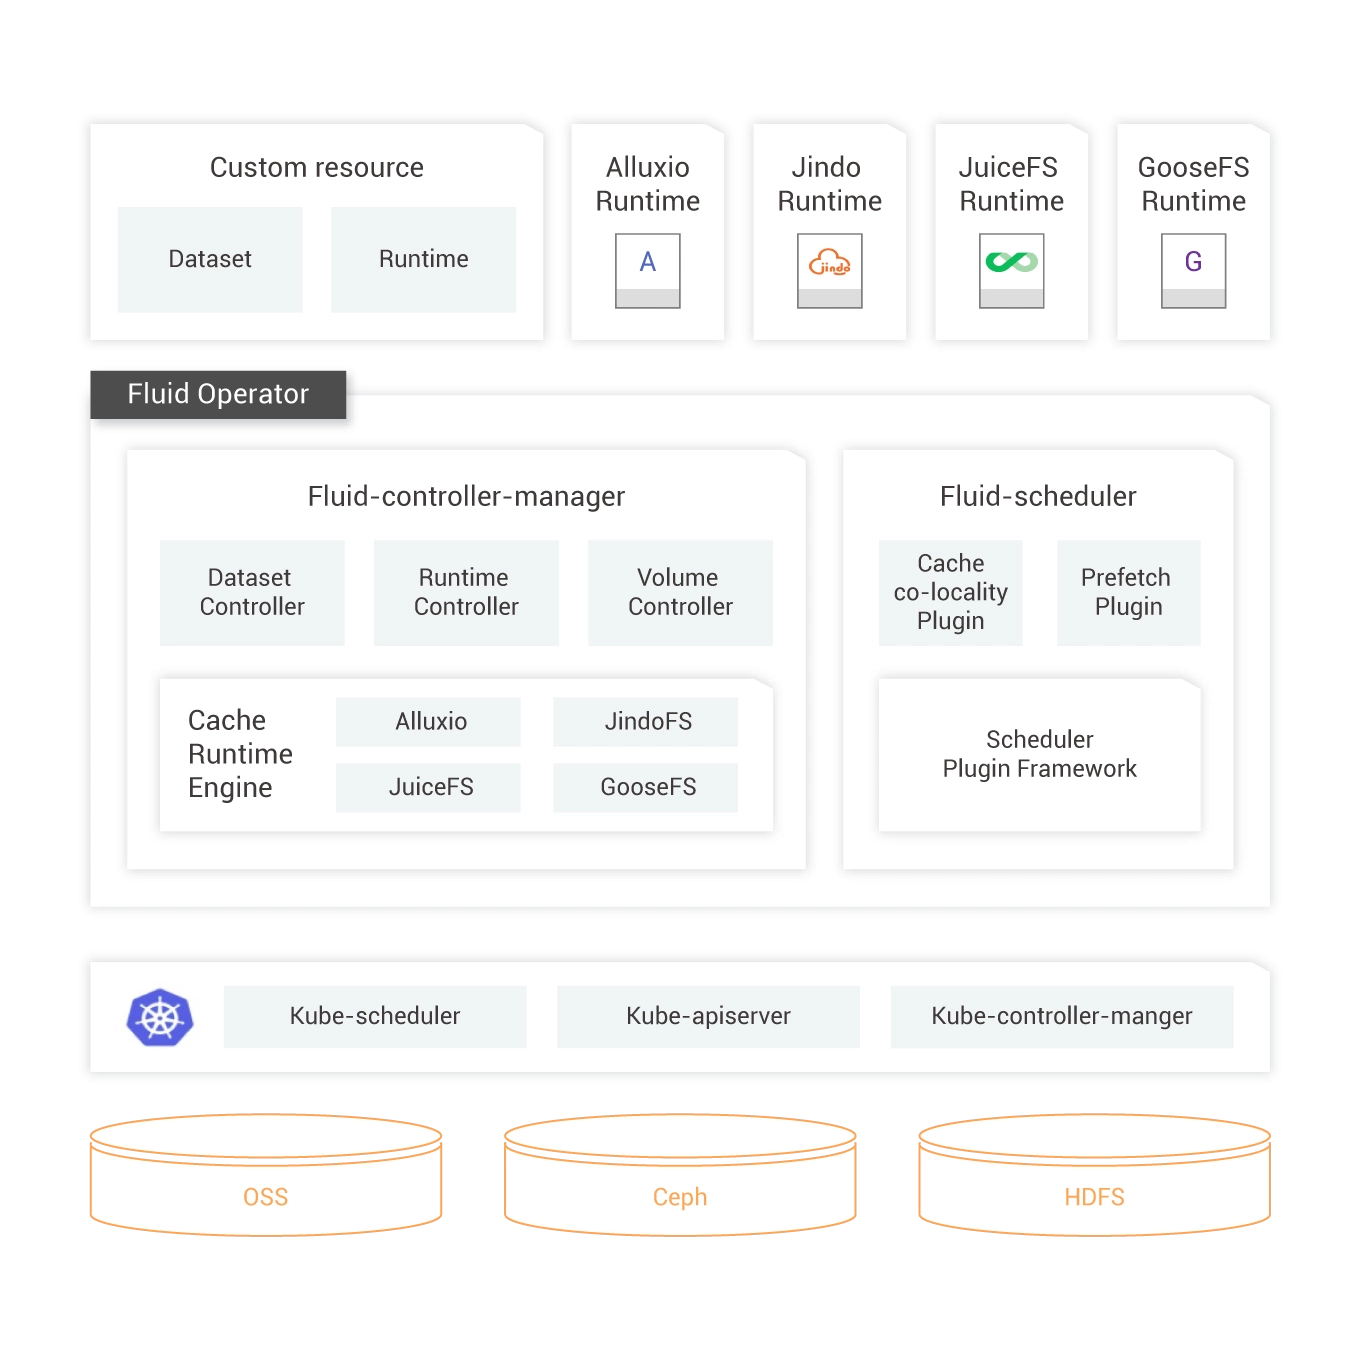
Compatibilidad nativa con la abstracción de conjuntos de datos
Cloud-native AI empaqueta en funciones las capacidades fundamentales que requieren las aplicaciones de uso intensivo de datos. De este modo, se logra un acceso eficiente a los datos y se reducen los costos de administración de datos heterogéneos.
-
Precarga y aceleración de datos en la nube
Fluid usa motores de caché distribuida para admitir la precarga y la aceleración de datos en la nube. Esto garantiza la observabilidad, la portabilidad y la escalabilidad horizontal automática de los datos en caché.
-
Orquestación colaborativa de datos y aplicaciones
Cuando programa aplicaciones y datos en la nube, puede coordinar la orquestación de aplicaciones y datos según sus características y ubicaciones para mejorar el rendimiento general.
-
Administración de espacios de nombres
Puede acceder a datos de varias fuentes de datos al mismo tiempo en un solo conjunto de datos. Las fuentes de datos incluyen Object Storage Service (OSS), Hadoop Distributed File System (HDFS), Ceph y otros servicios de almacenamiento. Esto es adecuado para escenarios de nube híbrida.
-
Administración de fuentes de datos heterogéneas
Puede acceder a datos de varias fuentes de datos al mismo tiempo en un solo conjunto de datos. Las fuentes de datos incluyen Object Storage Service (OSS), Hadoop Distributed File System (HDFS), Ceph y otros servicios de almacenamiento. Esto es adecuado para escenarios de nube híbrida.
Beneficios
-
Uso compartido y programación de GPU
Puede ejecutar varios contenedores en una GPU mediante el uso compartido y la programación de GPU.
-
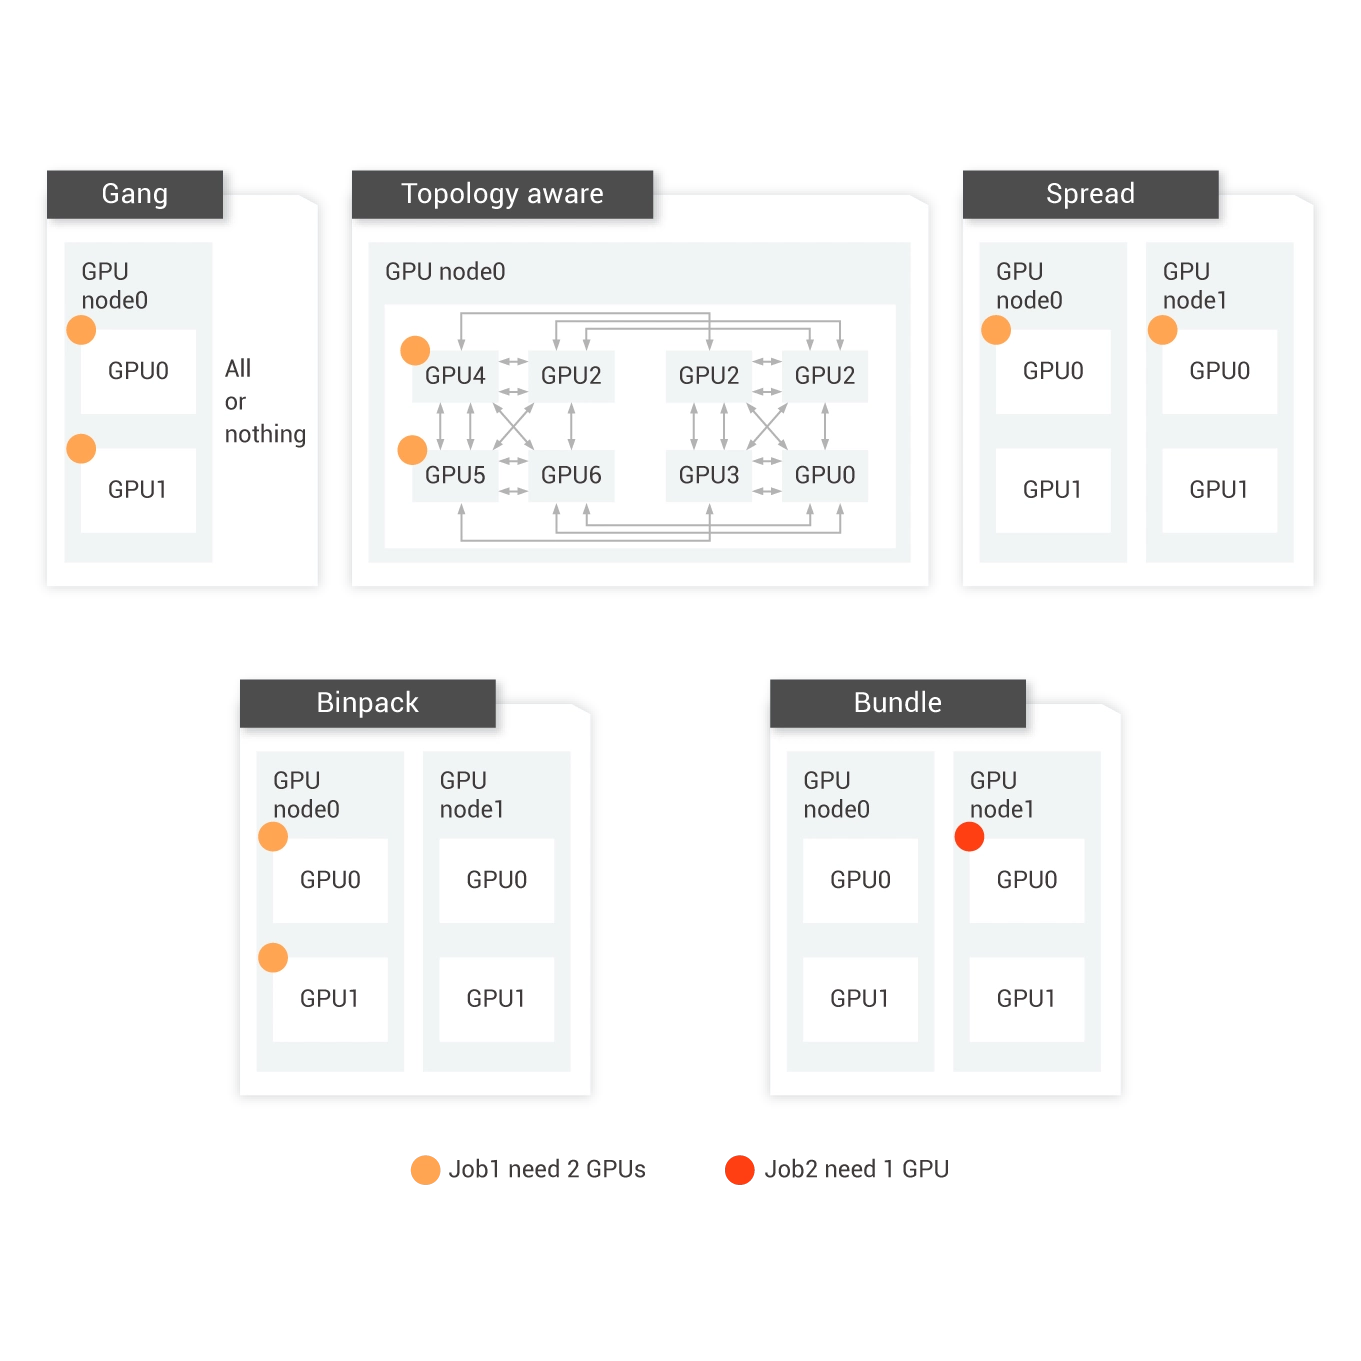
Programación GPU topológica
Puede seleccionar una combinación de GPU adecuada y lograr una velocidad de entrenamiento óptima durante la programación de GPU.
-
Binpack Scheduling
Las tareas se asignan inicialmente a un nodo. Cuando el nodo tiene recursos insuficientes, las tareas se asignan a otro nodo. Esto minimiza la transmisión de datos entre nodos y evita la fragmentación de recursos.
-
Gang Scheduling
Los recursos se asignan a una tarea sólo cuando todas sus subtareas cuentan con recursos suficientes. Esto evita interbloqueos de recursos en los que las tareas grandes acaparan los recursos de las tareas pequeñas.
Beneficios
-
Arena AI Toolkit
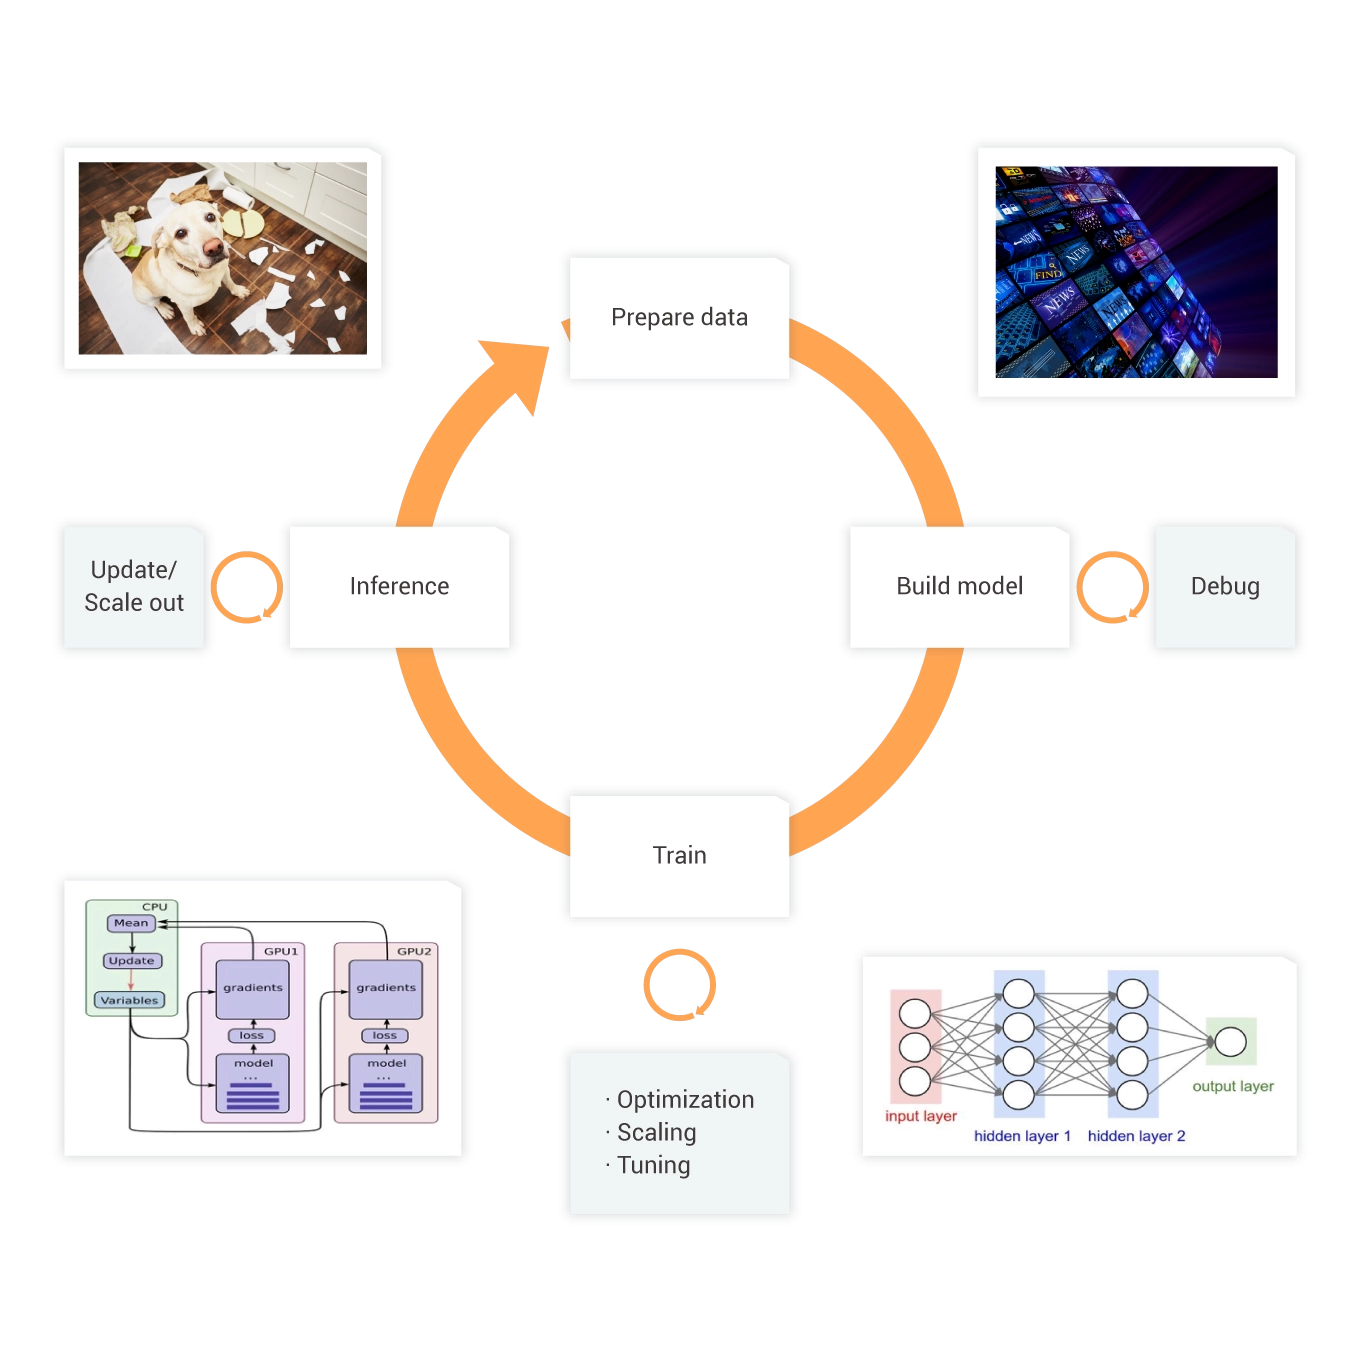
Las líneas de comandos y los SDK de Go, Java y Python son compatibles con los recursos heterogéneos subyacentes. Esto permite administrar entornos, programar tareas, asignar GPU y monitorear recursos de manera simplificada.
-
El toolkit es compatible con diversos frameworks de aprendizaje profundo, como TensorFlow, PyTorch, Caffe, Message Passing Interface (MPI) y Hovorod. El toolkit cubre todo el proceso de la administración de la operacionalización de modelos de aprendizaje automático (MLOps), que incluye la administración de conjuntos de datos de entrenamiento, la administración de tareas de IA, el desarrollo de modelos, el entrenamiento distribuido, la evaluación y la publicación de modelos de inferencia.
-
La consola de I+D proporciona un entorno de desarrollo de algoritmos bajo demanda en el que puede realizar operaciones de administración durante todo el ciclo de vida de I+D. Estas operaciones incluyen la administración de notebooks, la administración de tareas de IA, la administración de modelos y la publicación de modelos.
Beneficios
-
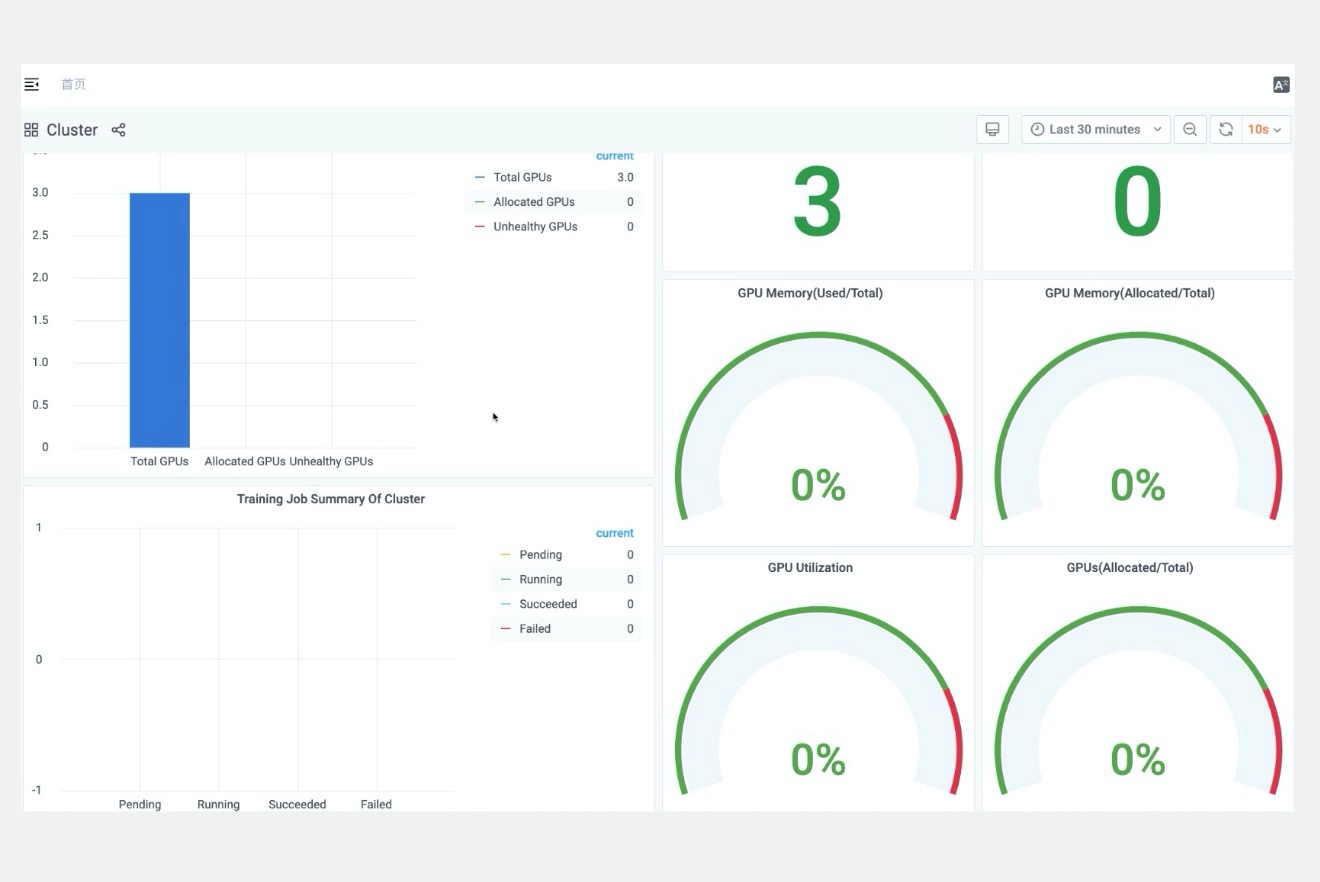
Paneles de control de utilización de GPU en tiempo real
Puede monitorear la utilización de recursos desde múltiples dimensiones en tiempo real.
-
Administración y aceleración de conjuntos de datos
Puede acelerar el acceso a los conjuntos de datos existentes con un clic para mejorar la eficiencia.
-
Administración de usuarios y grupos de usuarios
Puede crear usuarios y grupos de usuarios con base en proyectos, y administrar permisos de usuario y cuotas de manera granular.
-
Administración de cuotas elásticas
La programación de capacidad permite a los grupos de usuarios compartir recursos dinámicamente.

